
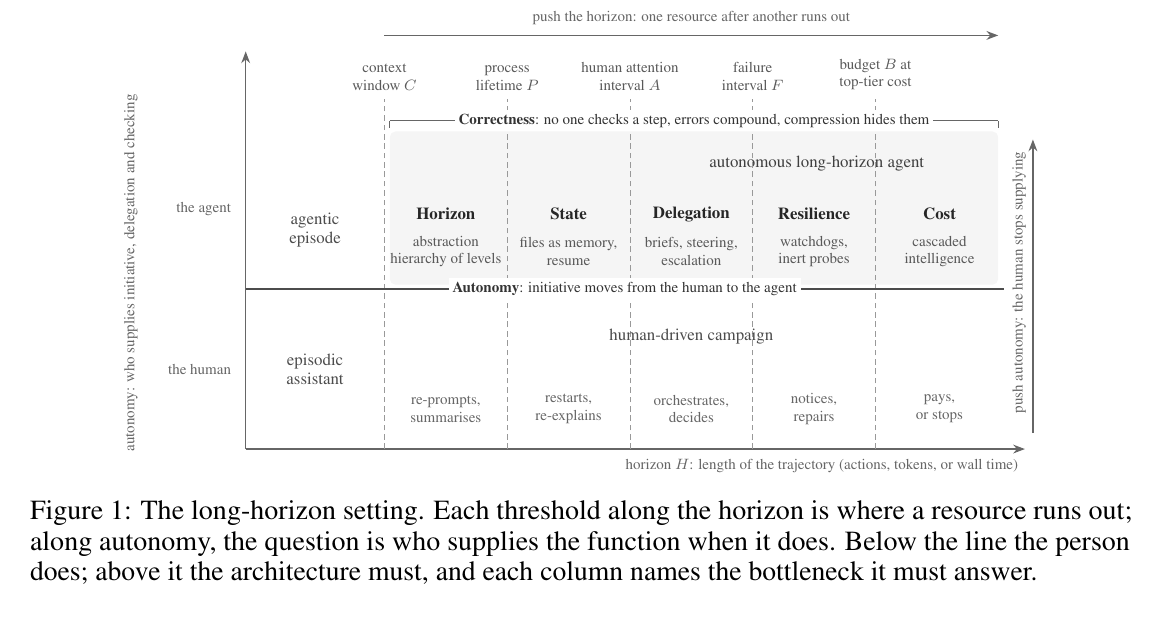
「Figure 1, Nijkamp et al., arXiv:2609.19519」 The long-horizon setting. Each threshold along the horizon is where a resource runs out.

며칠·몇 주짜리 일을 언어 모델 에이전트에 맡기는 말이 늘었습니다. 운영 장애 대응이나 연구 프로그램처럼, 한 번의 컨텍스트 창이나 한 프로세스보다 긴 과제입니다. 그런데 배포된 에이전트는 여전히 에피소드 안에서 멈추는 경우가 많습니다. 창이 끝나면 다음 시작과 기억은 사람에게 돌아갑니다.
2026년 9월 17일 arXiv에 오른 An Architecture for Long-Horizon Agents: Levels, Ticks and Cascaded Intelligence(arXiv:2609.19519)는 그 경계를 하네스(모델 바깥의 운영 층) 문제로 봅니다. Erik Nijkamp·Anurag Koul·Egor Pakhomov·Bo Pang(Salesforce AI Research)은 긴 지평에서 나오는 일곱 병목을 정리하고, 시간 척도로 나눈 레벨, 시계형 틱, 검토 후 올리는 cascaded intelligence로 답합니다.
답을 먼저 말하면, 가중치 갱신 없이 10일·드라이버 틱 211회·GPU 2,215/3,000시간으로 공개 async RL 결과(Hou et al., arXiv:2607.07508)를 재현했다고 보고합니다. 같은 표의 두 번째 성적표는 routine 노동 86%·strong 14%, 에스컬레이션 25회·principal-only 9회입니다. 앞선 Paper Review로는 State of Thought, 토큰 62.6%·지연 44.6%가 있습니다.
1. 한눈에 보는 숫자
부록 Table 1이 프로젝트 기록에서 집계한 캠페인 숫자입니다. 표에 적힌 값을 그대로 옮깁니다.
| 항목 | 수치 | 출처 |
|---|---|---|
| 달력 일수 / 시계 가동 일수 | 10 / 8 | Table 1 |
| driver ticks / context resets | 211 / 47 | Table 1 |
| worker sessions, routine / strong | 403 / 35 | Table 1 |
| 실험 | ≈ 40 | Table 1 |
| adversarial reviews / critical findings | 30 / 7 | Table 1 |
| escalations / principal-only decisions | 25 / 9 | Table 1 |
| judgment 티어 분석 세션 | 25 | Table 1 |
| GPU-hours used / cap | 2,215 / 3,000 | Table 1 |
| labor spend, routine / strong | 86% / 14% | Table 1 |
헤드라인용 한 줄은 「열흘·재현 성공」입니다. 같은 표의 첫 층은 틱 211회와 컨텍스트 리셋 47회입니다. 리셋마다 스레드를 잃지 않았다는 주장이 이 숫자에 기대고 있습니다.
2. 일곱 병목과 Figure 1 설정
설정은 두 축입니다. 자율성은 사람 없이 에이전트가 가져가는 결정의 몫이고, 지평 H는 목표에 닿기까지 유지해야 하는 궤적의 길이입니다. 행동·토큰·벽시계로 잴 수 있습니다.
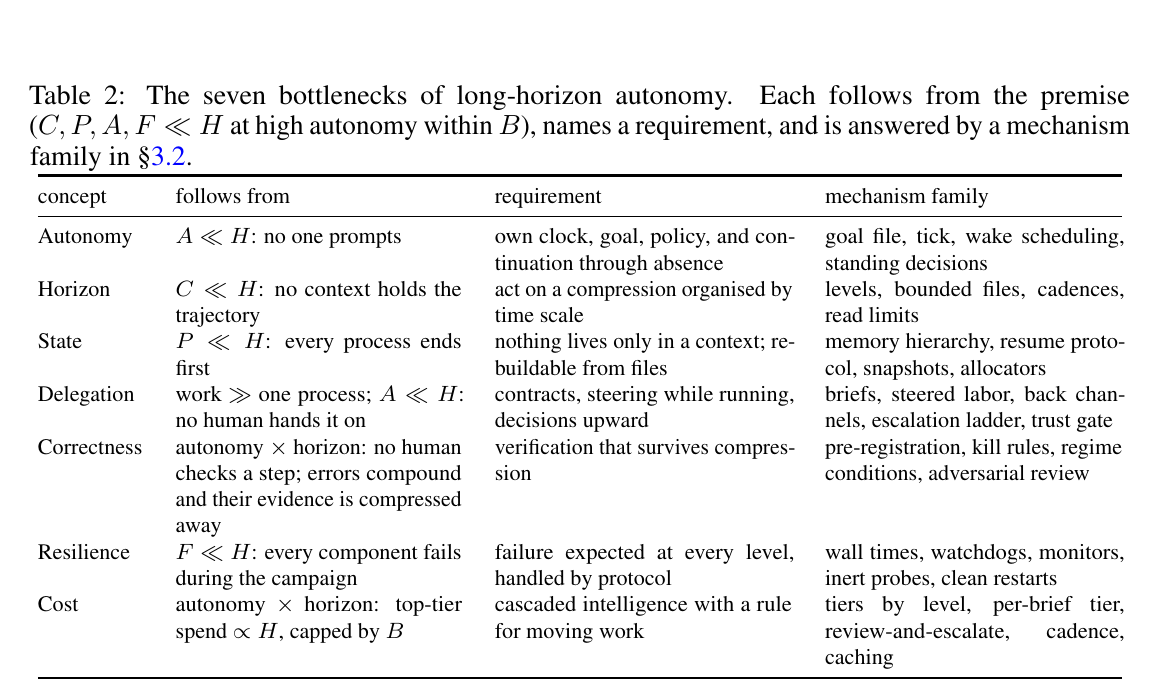
지평 축 위에는 네 임계가 있습니다. 한 호출의 컨텍스트 C, 한 프로세스의 수명 P, principal이 들여다보는 간격 A, 의존 부품의 실패 간격 F입니다. 자율성이 높으면 누가 그 교차점을 받아 주지 않습니다. 여기에 정확성과 비용이 더해집니다. 검사자가 없으면 오류가 쌓이고, 압축은 그 증거를 가립니다. 최상위 모델 단가로 H가 불어나면 예산 B가 상한을 잡습니다.
일곱 병목은 Autonomy, Horizon, State, Resilience, Delegation, Correctness, Cost입니다. 부록 Table 2가 각 병목을 요구사항과 메커니즘 패밀리로 연결합니다. 이 표는 설계 체크리스트로 읽는 편이 맞습니다. 벤치마크 순위표가 아닙니다. Figure 1은 사람 아래·아키텍처 위로 나눈 「긴 지평 설정」을 한눈에 보여 줍니다.
3. 레벨 L0–L6과 Figure 2
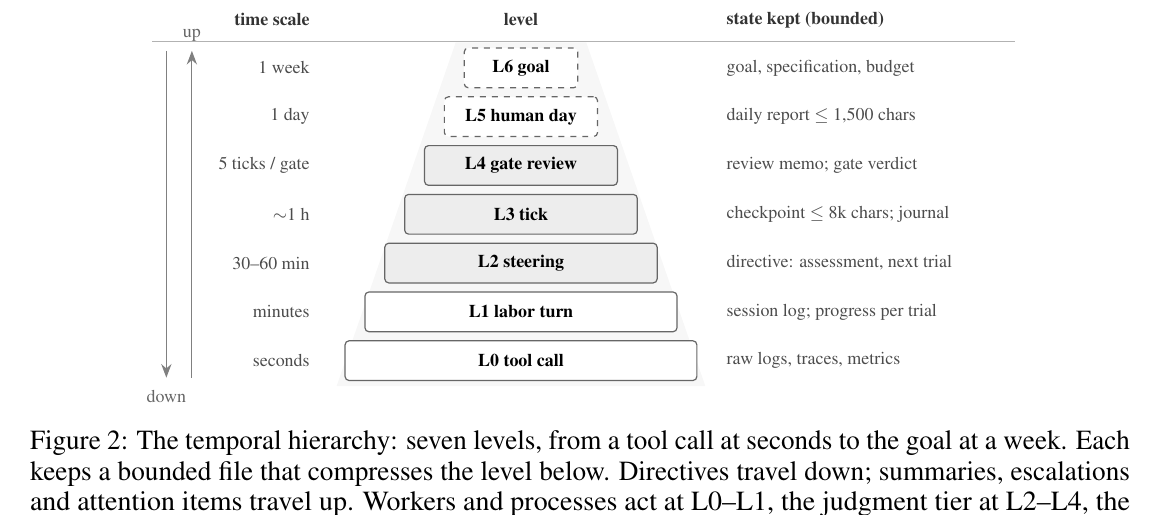
아키텍처의 첫 추상은 level입니다. 작용하는 시간 척도로 층을 가르고, 아래 층을 압축한 유한 파일을 유지합니다. Figure 2의 경계를 옮깁니다.
L6 goal(약 1주): 목표·명세·예산. L5 human day(1일): 일일 보고 ≤ 1,500자. L4 gate review(약 5틱/게이트): 리뷰 메모·게이트 판정. L3 tick(약 1시간): 체크포인트 ≤ 8k자·저널. L2 steering(30–60분): 지시—평가와 다음 시도. L1 labor turn(분): 세션 로그·시도별 진행. L0 tool call(초): 원시 로그·트레이스·메트릭.
아래로 가는 채널은 드문드문 내려가는 지시(steering)입니다. 위로 가는 채널은 압축된 상태, 에스컬레이션, 주의 항목, kill 판정입니다. kill만은 압축을 건너뜁니다. 압축이 가릴 메시지이기 때문입니다. 노동자·프로세스는 L0–L1, 판단 계층은 L2–L4, principal은 L5–L6에 둡니다.
4. 틱·프로토콜·티어
tick은 판단이 머무는 층에서 한 번의 자율 행동 단위입니다. 드라이버가 한 번 깨어 상태를 읽고, 미리 등록한 규칙을 적용하고, 결정·행동한 뒤 상태를 다시 씁니다. 시계가 새 드라이버 세션을 시작하고, 드라이버가 써 둔 간격만큼 잡니다. 세션을 끝내기 전에 틱 수준 상태 파일(체크포인트)을 쓰게 훅이 막습니다.
프로토콜은 이름 있는 파일입니다. 작성자·독자·주기·검사가 정해져 있습니다. 채널과 내구성 상태 모두가 프로토콜입니다. 지능은 세 티어—judgment, labor(routine 또는 strong; 세션은 worker), deterministic process—로 나뉩니다. 티어는 레벨과 함께 올라갑니다.
5. Cascaded intelligence — 검토한 뒤에만 올린다
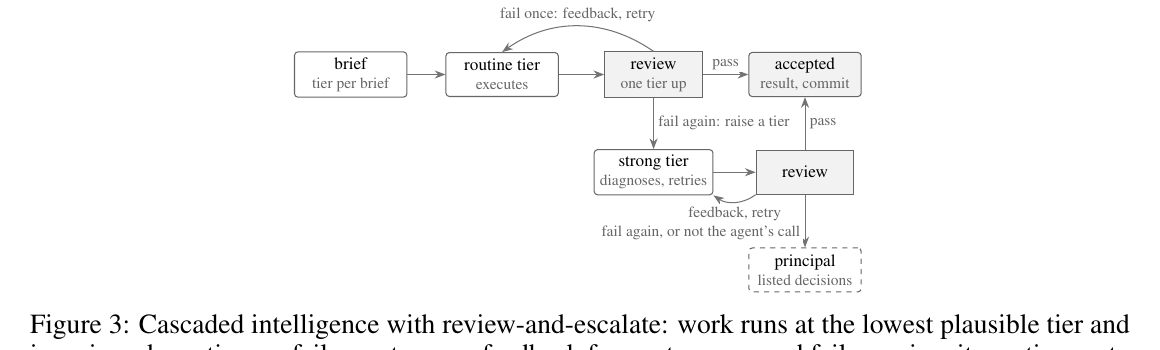
비용 병목에 대한 답이 review-and-escalate입니다. 일은 그럴듯한 가장 낮은 티어에서 돌리고, 한 티어 위에서 검토합니다. 실패하면 피드백을 주고 재시도합니다. 다시 실패하면 한 티어를 올립니다. principal까지 갈 수 있습니다.
강한 티어는 「일이 크다」가 아니라 「틀리면 비용이 크다」로 배정합니다. 사다리는 대칭입니다. 강한 티어가 레시피를 찾으면, 후속은 그 레시피를 brief에 넣어 routine에서 돌립니다. 세션은 몇 틱마다 교체해, 새 세션이 짧은 체크포인트만 읽게 합니다. 할 일이 없으면 규칙 기반 pre-tick digest가 깨우기를 건너뜁니다. Figure 3이 이 흐름을 그립니다.
6. 열흘 캠페인 결과 — Hou et al. async RL 재현
과제는 Hou et al., 2026(arXiv:2607.07508)의 비동기 강화학습 결과 재현입니다. 오래된 정책에서 뽑은 stale rollout으로 학습하면 일정 지연 임계를 넘을 때 정책이 붕괴하고, 분리된 importance-sampling 보정이 안정성을 유지한다는 주장입니다. 두 모델 스케일에서입니다.
캠페인은 다섯 게이트 단계를 거칩니다. 환경 기동, 소규모에서의 보정 전후 안정성 쌍, 대형 모델의 단일 노드 레시피와 그 스케일의 안정성 쌍, 두 번째 프레임워크로의 이식(요청값이 아니라 실제로 측정된 staleness로 검증), 효과성 비교(전체 방법 대 대조)입니다. 결과는 공개된 수치를 재현했다고 적혀 있습니다. 보정하지 않은 정책은 두 스케일 모두에서 임계를 넘어 붕괴했고, 보정한 정책은 버텼습니다.
비네트 한 줄만 더합니다. 조향 없는 worker 세션 세 번이 스텝당 958초에서 진단 없이 끝났고, 드라이버가 30분마다 directive를 내린 뒤 한 유한 세션 안에서 스텝 시간은 180초로 줄었습니다. 레시피는 strong 티어 없이 유지됐습니다. 에이전트는 파라미터를 갱신하지 않았습니다. 그래도 초기에 적어 둔 운영 지식이 나중 행동을 바꿨다고 봅니다. 논문은 이를 학습이 아니라 축적이라 부릅니다.
한계는 단일 배포·한 번의 캠페인입니다. 벤치마크가 아니라 존재 증명입니다. 「열흘 만에 재현」만 남기면 GPU 여유·routine 편향·에스컬레이션 사다리가 지워집니다.
7. ✔ 요약과 공식 링크
✔ 긴 지평 에이전트는 먼저 잊지 않고 계속 돌아가야 하고, 그 능력은 모델이 아니라 하네스에 있다고 봅니다.
✔ 일곱 병목에 대해 레벨·틱·프로토콜·cascaded intelligence(review-and-escalate)로 답합니다. L5 일일 보고 ≤ 1,500자, L3 체크포인트 ≤ 8k자.
✔ Table 1: 10일·틱 211/리셋 47·GPU 2,215/3,000·routine 86%/strong 14%·에스컬레이션 25/principal-only 9.
✔ Hou et al. async RL 재현: 보정 전 붕괴·보정 후 유지. 가중치 갱신 없이 파일에 남는 축적.
✔ 단일 캠페인 존재 증명입니다. 이 글은 PDF·초록을 대조한 공개 요약이며 캠페인·GPU를 다시 돌리지는 않았습니다.
읽은 범위: arXiv abs HTML + PDF(paper.pdf) 본문 §1–5·부록 Table 1–2·Figure 1–3. 코드/프로젝트 URL은 본문에 없음. 부록 전량·재실행은 하지 않음.
공식 링크
- arXiv abs: https://arxiv.org/abs/2609.19519
- PDF: https://arxiv.org/pdf/2609.19519
제목: An Architecture for Long-Horizon Agents: Levels, Ticks and Cascaded Intelligence (Nijkamp et al., arXiv:2609.19519, 2026-09-17). 재현 대상: Hou et al., arXiv:2607.07508.