
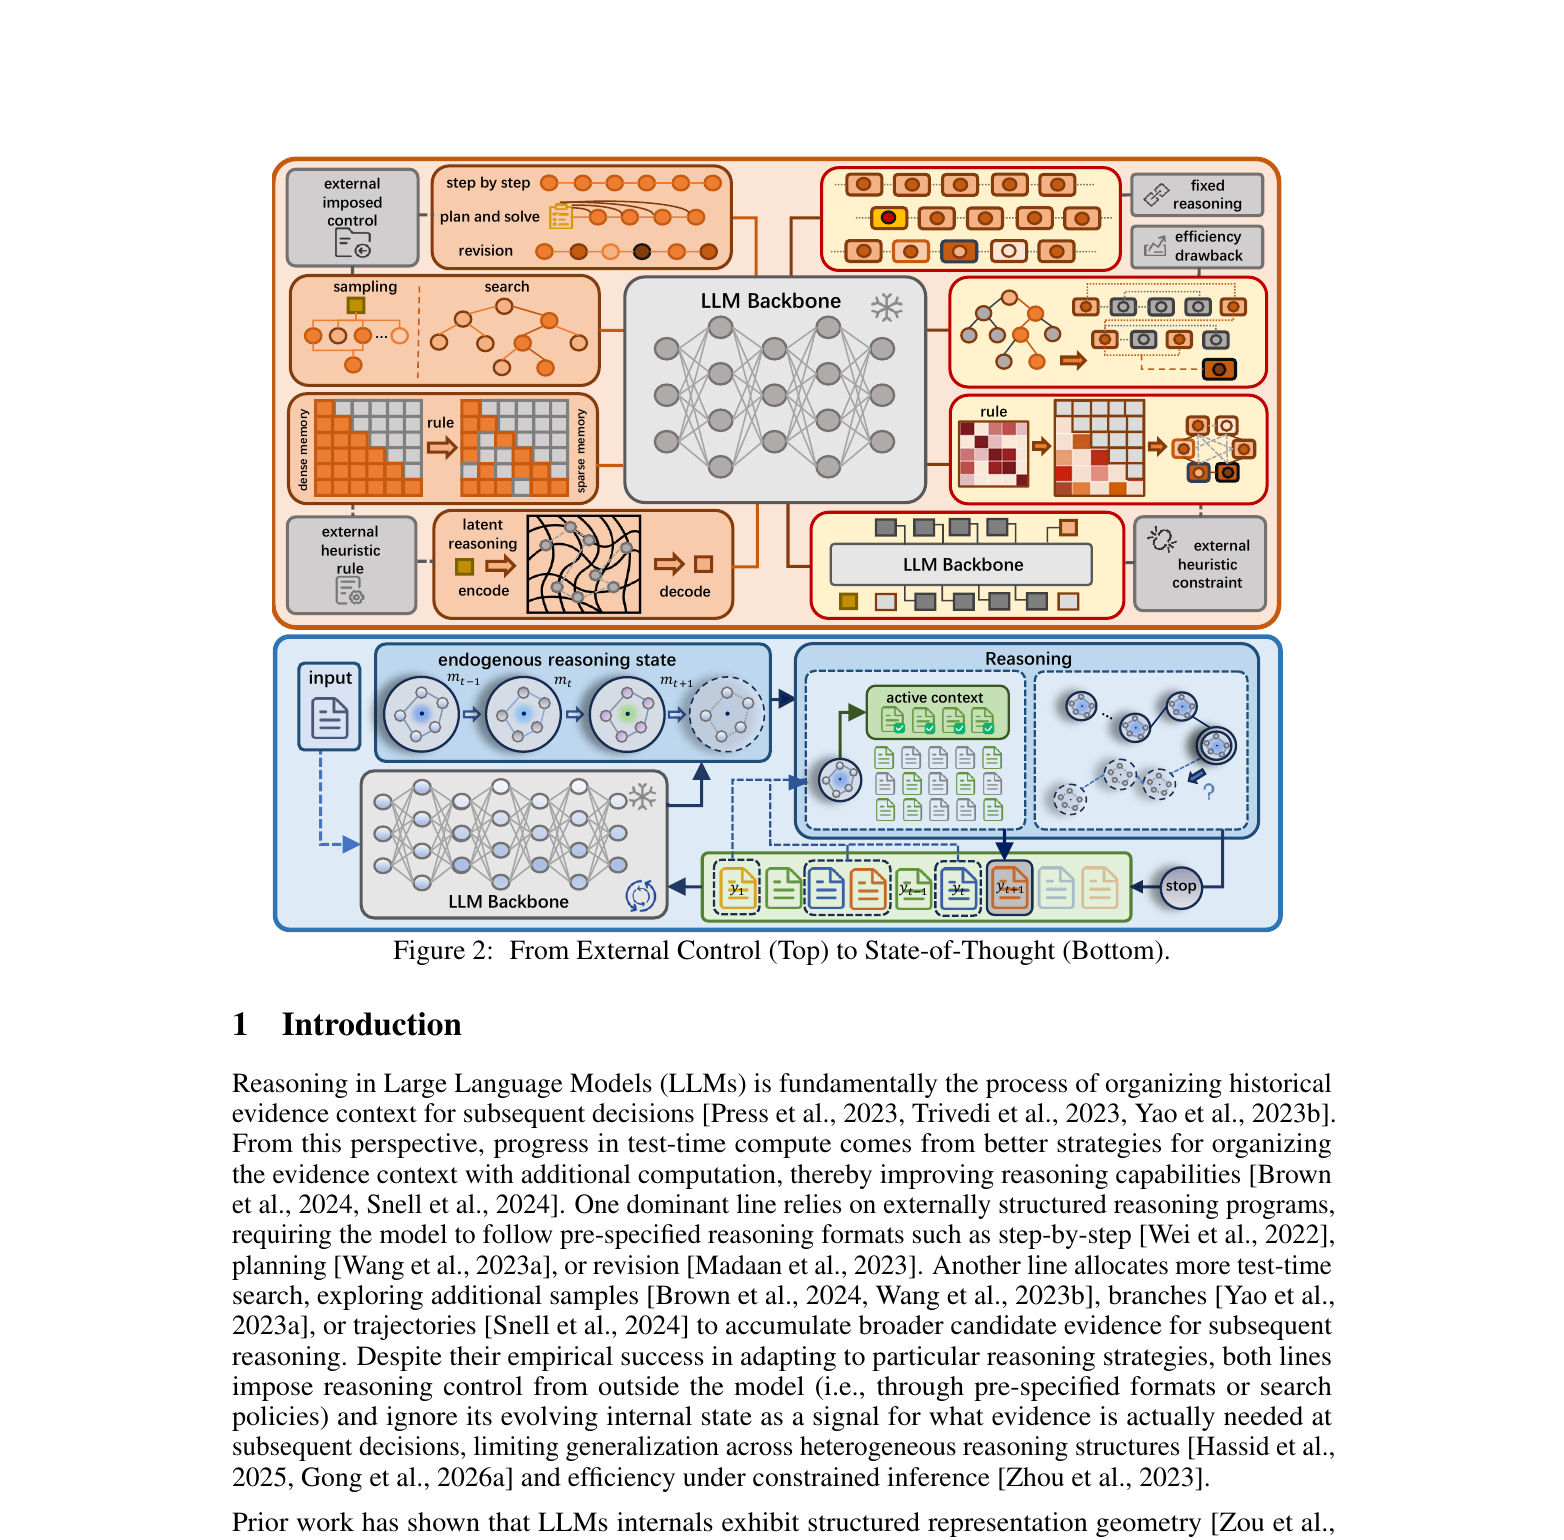
테스트 타임에 추론을 키우는 흔한 방법은 두 갈래입니다. 하나는 단계별·계획·수정을 외부에서 박아 넣는 스크립트이고, 다른 하나는 샘플·가지·경로를 넓혀 후보를 쌓는 탐색입니다. 둘 다 「밖에서」 추론을 조종합니다.
2026년 9월 13일 arXiv에 오른 State of Thought Enables Endogenous Reasoning(arXiv:2609.16055)는 그 축을 뒤집습니다. Zhiren Gong·Yikun Hou·Zihao Zeng·Ming Xiao·Chau Yuen·Wei Yang Bryan Lim(NTU·KTH)은 모델 내부의 동역학·기하 상태를 읽어, 지금 상태에 맞는 과거 증거만 켜고 멈출 시점도 상태로 정합니다. 백본은 얼린 채 582파라미터 컨트롤러만 둡니다.
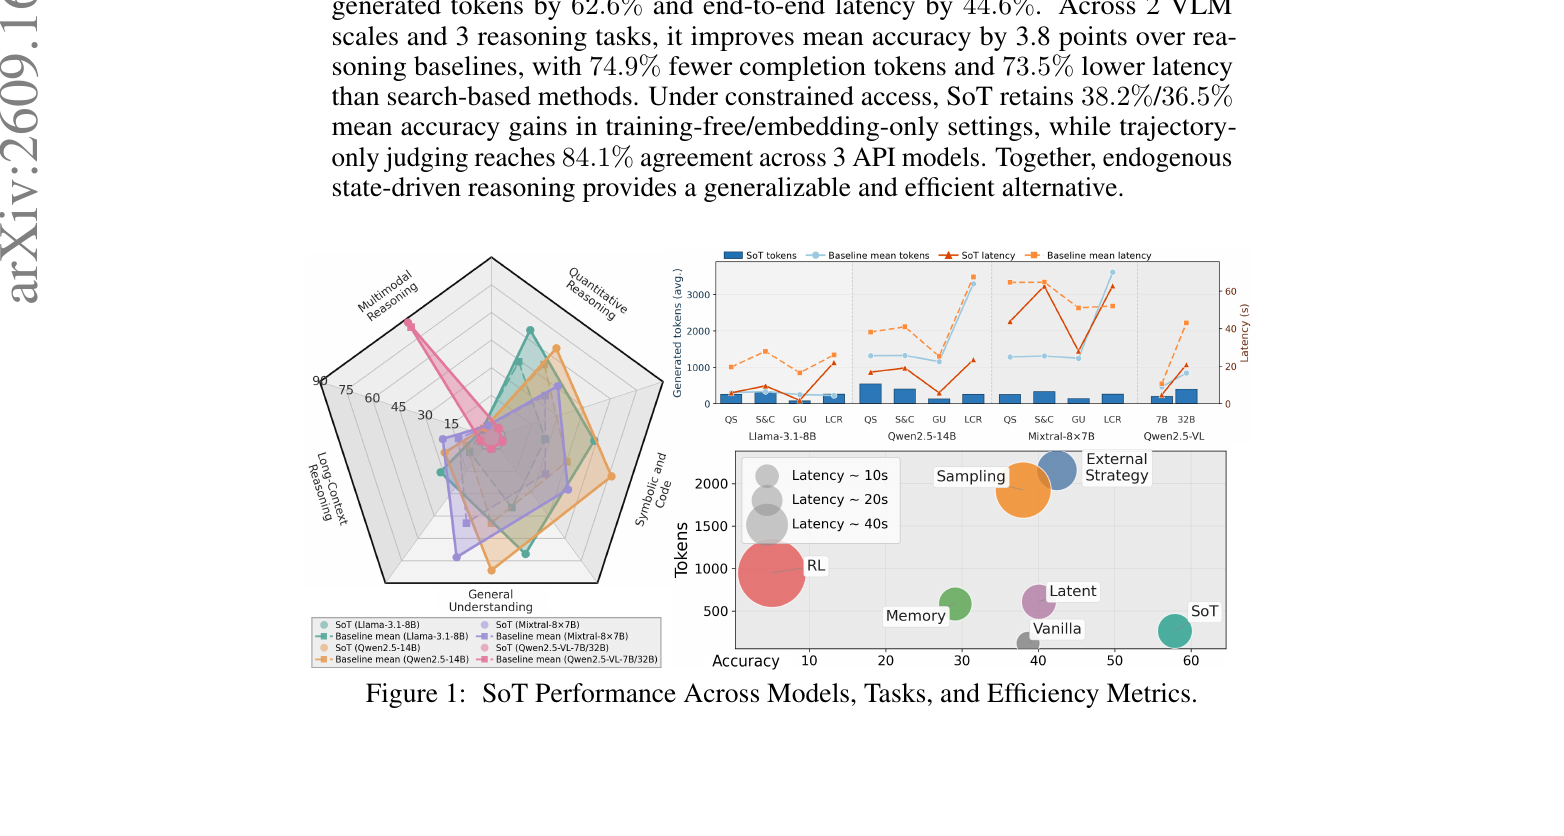
답을 먼저 말하면, 3개 LLM·16개 데이터세트에서 mean-baseline 정확도를 올리면서 생성 토큰을 62.6%, 종단 지연을 44.6% 줄였다고 초록이 적습니다. 영역별 배수(초록)는 정량 1.34×, 일반 1.62×, 기호·코드 1.76×, 장문맥 2.51×입니다. VLM 2스케일·3과제에서는 추론 기준선 대비 평균 정확도 +3.8점, 탐색 대비 완료 토큰 74.9%·지연 73.5% 감소입니다. 앞선 Paper Review로는 RSIAgent, OSWorld Partial 78.98·Astra +6.38%p가 있습니다.
1. 한눈에 보는 숫자
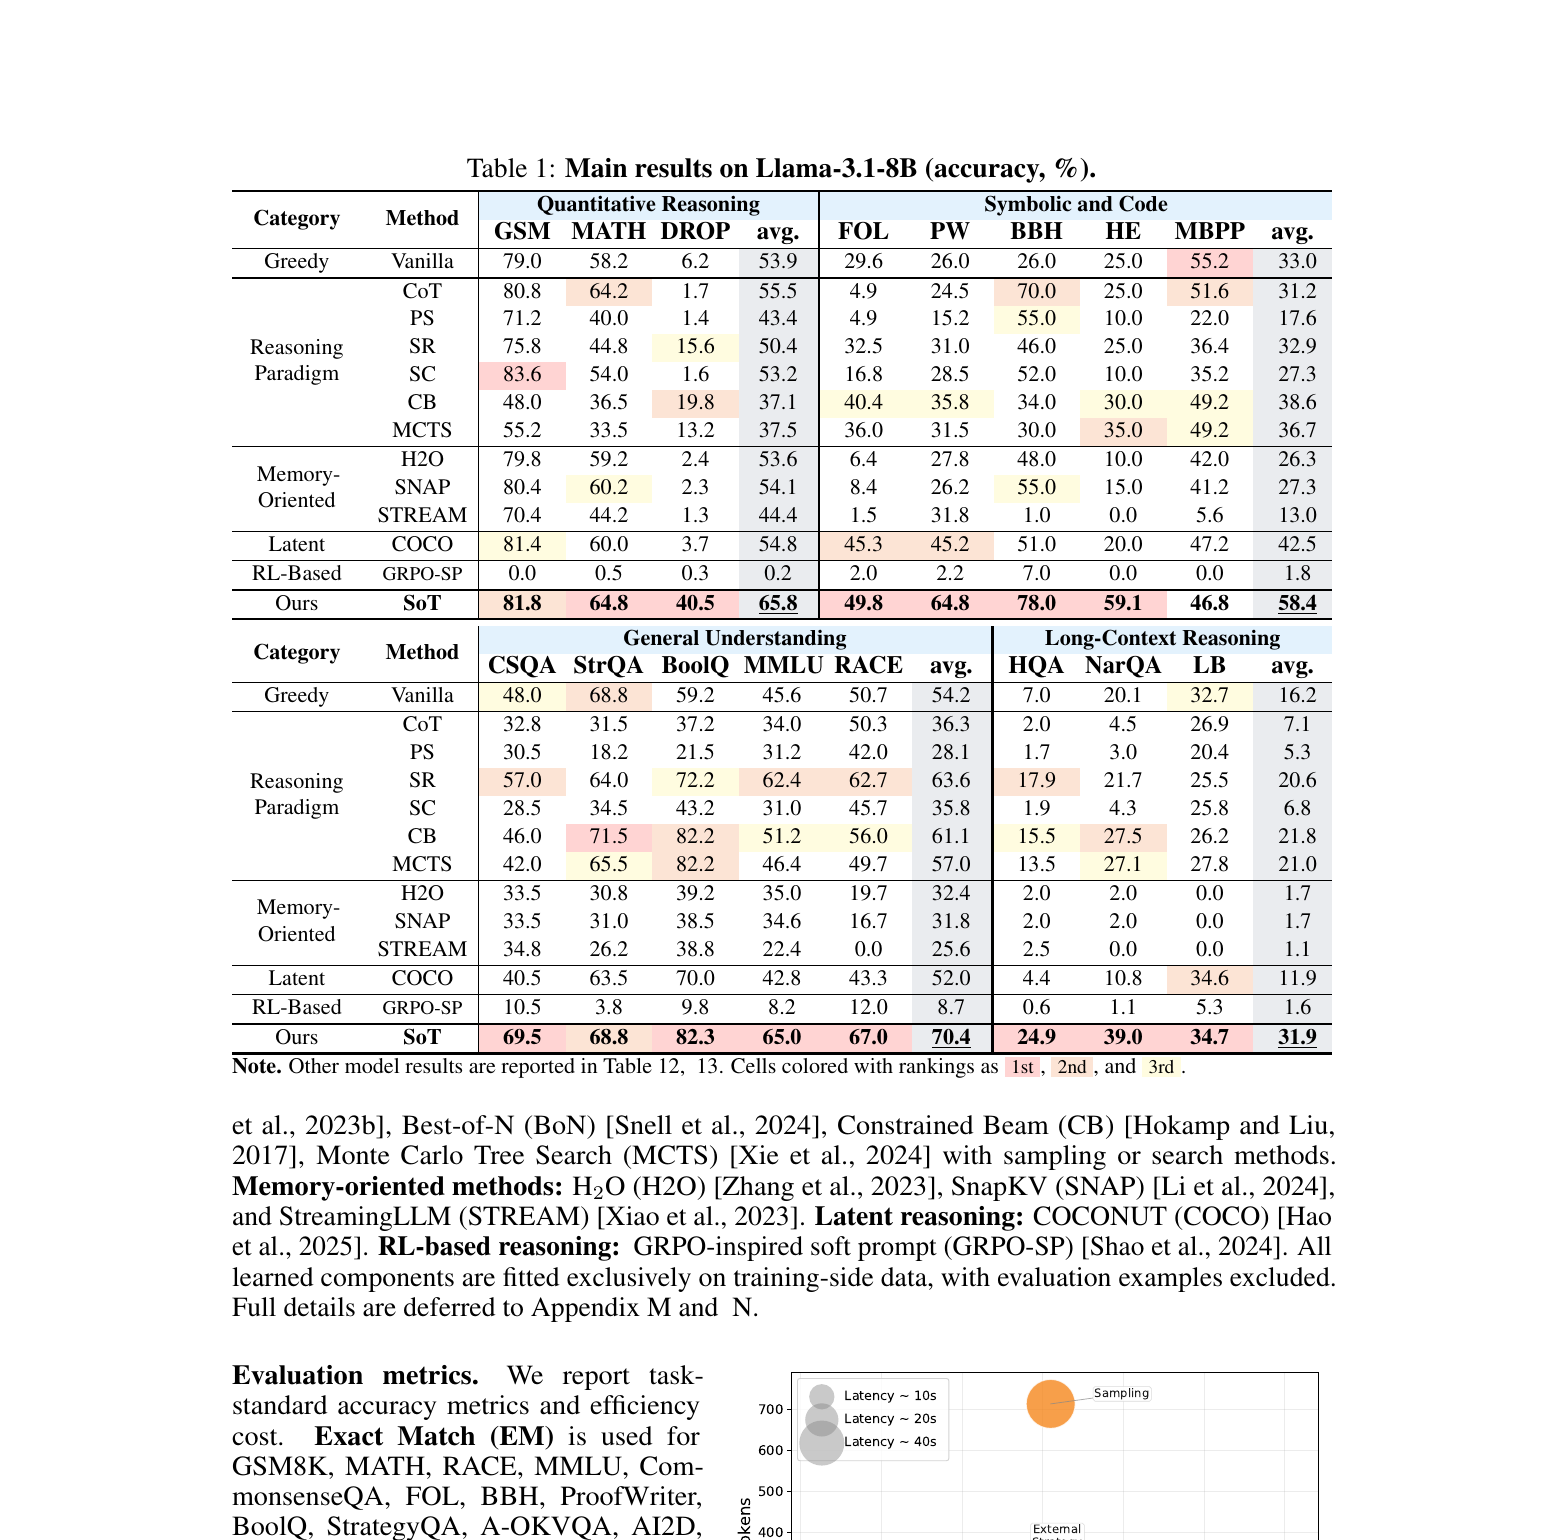
초록·서론·Table 1(Llama-3.1-8B 도메인 평균)의 핵심만 모았습니다. Llama 표의 Δ는 원문 §3.2가 「도메인별 최강 non-SoT 대비」로 보고한 점수 차입니다.
| 항목 | 수치 | 출처 |
|---|---|---|
| LLM 토큰 / 지연 | −62.6% / −44.6% | Abstract (3 LLM·16 sets) |
| 영역 배수 (mean-baseline) | QS 1.34× · GU 1.62× · S&C 1.76× · LCR 2.51× | Abstract |
| Llama 도메인 평균 (SoT) | QS 65.8 · S&C 58.4 · GU 70.4 · LCR 31.9 | Table 1 |
| Llama vs 도메인 최강 non-SoT | +10.3 / +15.9 / +6.8 / +10.1점 | §3.2 |
| VLM | 평균 +3.8점 · tok −74.9% · lat −73.5%(탐색 대비) | Abstract |
| 제한 접근 이득 유지 | training-free 38.2% / embedding-only 36.5% | Abstract |
| 궤적만으로 판정 합의 | 84.1%(API 모델 3개) | Abstract |
| 컨트롤러 | 582 params · backbone frozen | Abstract · §2.3 |
주의할 점 하나. §3.3의 Llama 단독 비교(샘플·탐색 대비 토큰 −52.6%·지연 −66.4%)는 초록의 3모델 집계(−62.6%/−44.6%)와 범위가 다릅니다. 헤드라인은 초록 숫자를, Llama 효율 문장은 §3.3을 씁니다.
2. SoT가 하는 일 — 외부 스크립트 대신 내부 상태
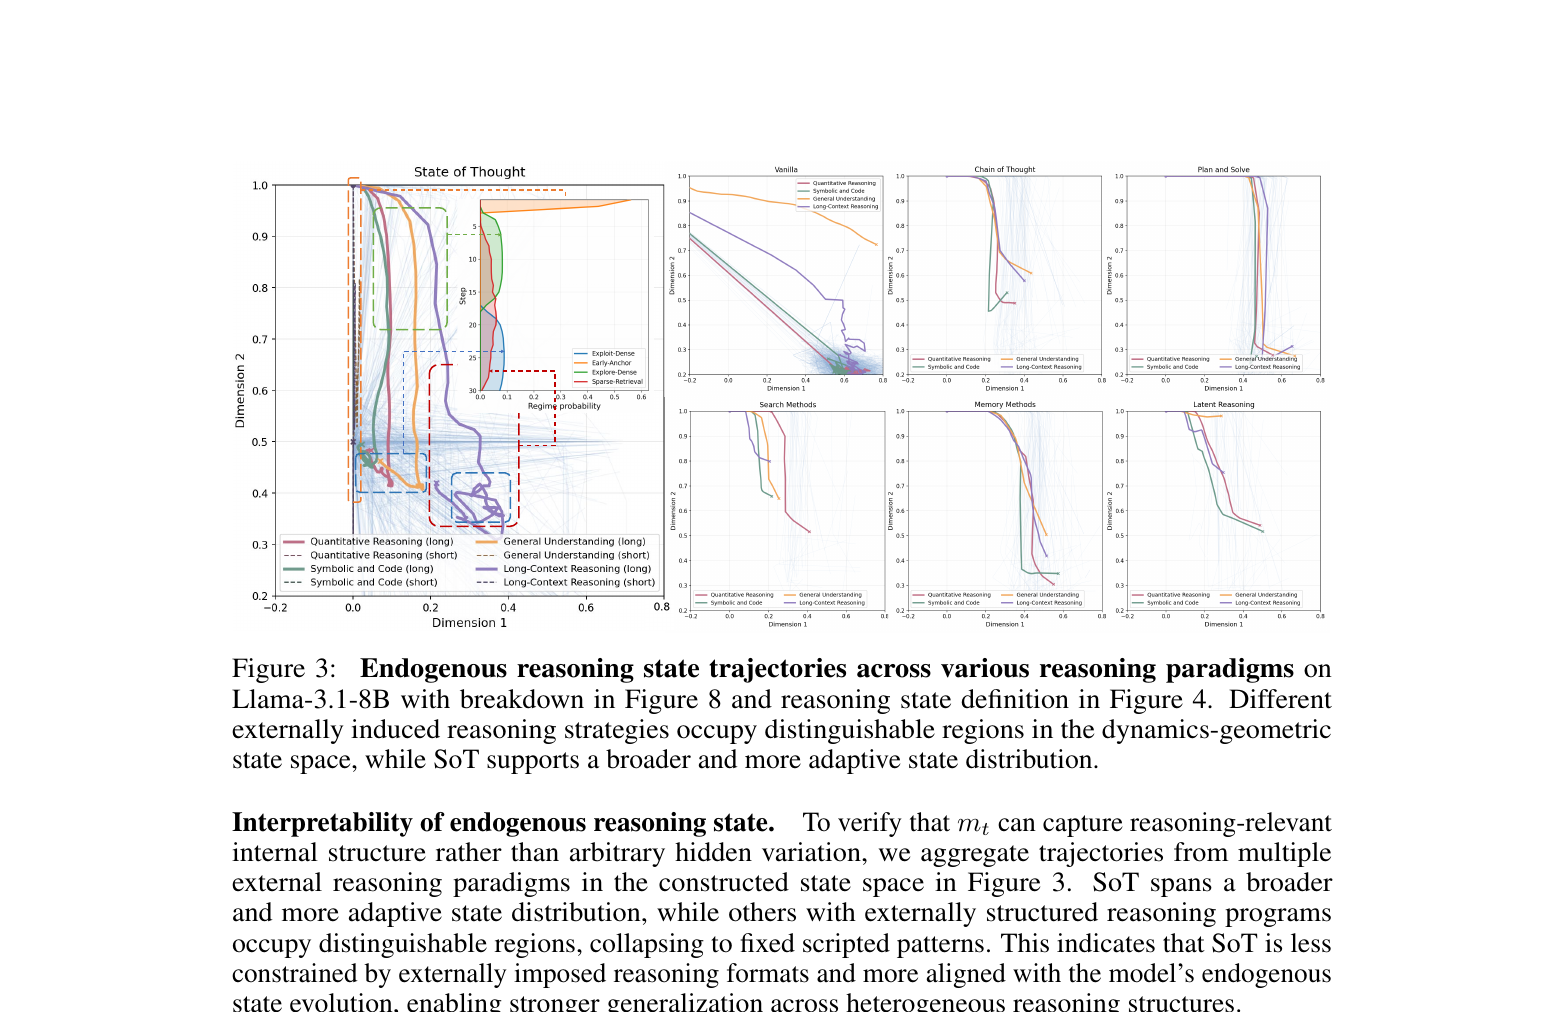
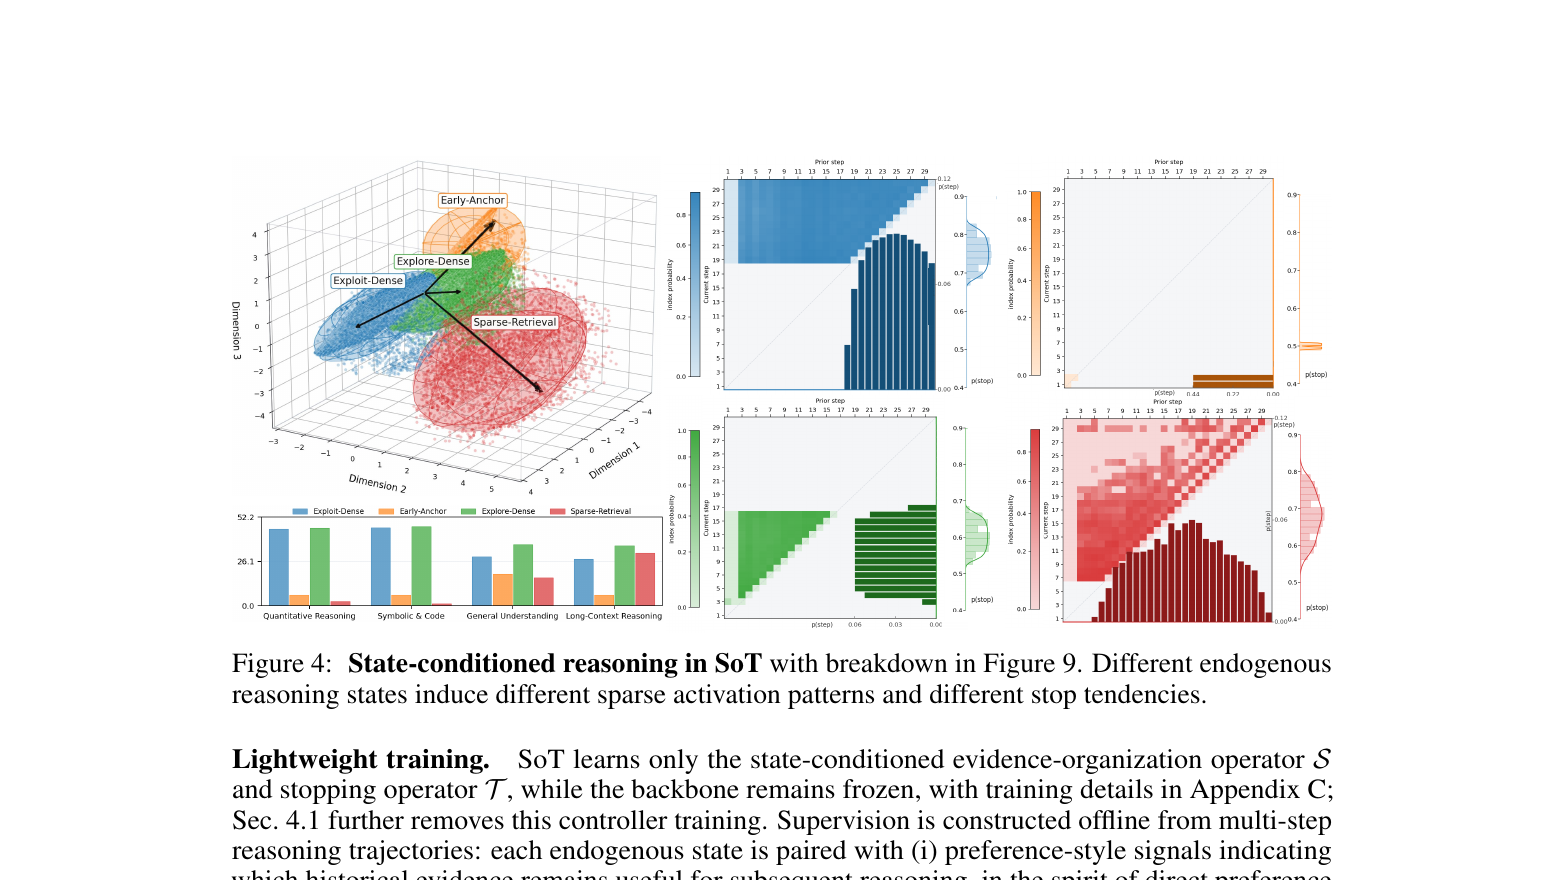
답부터 말하면, 매 추론 단계에서 내부 정보 전달로부터 압축 상태 mt=[δt, vt, ct, Ht]를 읽고, 그 상태로 (i) 과거 증거 중 쓸 것만 고르고 (ii) 계속할지·멈출지를 결정합니다.
δt는 국소 구조가 집중인지·확산인지, vt는 단계별 진행 크기, ct는 방향 일관성, Ht는 국소 예측 불확실성입니다. 증거 조직 연산자 S와 정지 연산자 T만 학습하고 백본은 고정입니다. §2.3은 선택 투영 16×32와 정지 헤드 4→1을 합쳐 582파라미터, 문제 홀드아웃 재적합 5회에서 selector AUC 0.779±0.005라고 적습니다. Figure 2는 위쪽 「외부 부과 제어」와 아래쪽 「내생 상태 루프」를 대비합니다.
3. Llama Table 1 — 네 도메인에서 도메인 평균 1위
Table 1(Llama-3.1-8B)에서 SoT 도메인 평균은 QS 65.8, S&C 58.4, GU 70.4, LCR 31.9입니다. §3.2는 도메인별 최강 non-SoT 대비 +10.3 / +15.9 / +6.8 / +10.1점(상대 18.6% / 37.4% / 10.7% / 46.3%)이라 적고, 16개 중 13개에서 최선·동률 최선이라고 합니다.
서론의 모델별 문장도 같이 둡니다. mean-baseline 대비 정확도 이득은 Llama-3.1-8B 89.8%, Qwen2.5-14B 58.6%, Mixtral-8x7B 46.0%이고, 토큰/지연 감소는 각각 19.7%/56.5%, 81.1%/62.2%, 86.8%/15.1%입니다. 「mean-baseline」이 어떤 베이스라인 평균인지에 따라 해석이 달라지므로, 절대 순위를 말할 때는 Table 1·12·13을 우선합니다.
4. 효율 — 토큰을 줄이되 압축만은 아닙니다
§3.3·Table 2는 Llama에서 SoT 평균 223.9토큰·9.8초, 샘플·탐색 계열 평균 472.7토큰·29.0초로 적어, 그 범위에서 토큰 52.6%·지연 66.4% 감소라고 합니다. QS/S&C/GU 지연은 각각 5.8s / 9.5s / 1.8s입니다.
원문은 메모리 압축 베이스라인이 토큰만 줄이고 정확도를 깎는 경우와 구별합니다. SoT는 「지금 상태에 필요한 증거」를 남겨 다음 결정을 버티게 한다고 주장합니다. Figure 5는 정확도–효율 전선을 옮긴다고 요약합니다.
헤드라인 −62.6%/−44.6%는 3 LLM·16세트 초록 집계이고, Llama §3.3의 −52.6%/−66.4%는 샘플·탐색 대비 단독 비교입니다. 범위를 섞지 말아야 합니다.
5. Ablation — 증거 조직 S와 정지 T를 빼면
Table 3(Llama) Full SoT는 QS/S&C/GU/LCR 정확도 62.8 / 54.5 / 71.2 / 33.0입니다. 증거 조직 S를 빼면 QS가 29.6으로 급락하고 토큰·지연이 커집니다. 정지 T를 빼면 정확도는 버티는 편이지만 토큰이 QS 1769.6, GU 4148.5처럼 폭증합니다. 기하 δt·동역학 (vt,ct)·불확실성 Ht를 하나씩 끄면 정확도·효율이 같이 흔들립니다.
숫자로 보면 「짧게만 자르기」가 아니라, 무엇을 남기고 언제 멈출지를 상태로 묶는 쪽이 SoT의 뼈대입니다.
6. VLM 이전 — +3.8점, 탐색보다 가벼운 완료
Table 4는 Qwen2.5-VL-7B/32B × A-OKVQA·AI2D·M3 CoT입니다. 7B SoT 예시는 A-OKVQA 87.5(191 tok, 4.4s), M3 CoT 87.3(198 tok, 4.5s)입니다. 32B SoT는 AI2D 90.0(364 tok, 19.2s) 등입니다. SC·BoN은 같은 표에서 토큰·지연이 훨씬 큽니다(예: 7B SC A-OKVQA 691 tok·15.9s).
초록·서론은 추론 기준선 대비 평균 +3.8점, 6개 모델–과제 중 5개 선두, 탐색 대비 완료 토큰 74.9%·지연 73.5% 감소라고 집계합니다.
7. 제한 접근과 궤적 판정
§4.1은 training-free·embedding-only 변형이 초록 집계로 mean accuracy gain 38.2% / 36.5%를 유지한다고 합니다. Table 5(Llama)는 Full SoT보다 각각 약 17.5% / 17.9% 낮다고도 적어, 「이득 유지」와 「Full 대비 하락」을 같이 읽어야 합니다.
§4.2 SoT-Judge는 완성 궤적만으로 정답 일치 여부를 예측합니다. API 모델 3개(GPT-5.4·Claude Opus 4.7·Qwen-Max)에서 궤적-only 합의 84.1%(초록)이고, Table 6은 최강 베이스라인 대비 평균 합의가 모델별로 +17.7 / +24.1 / +18.5점이라고 합니다. GU·S&C에서는 표준 판정이 더 강한 칸도 있어, 전 도메인 만능은 아닙니다.
8. ✔ 요약과 공식 링크
✔ SoT는 내부 4차원 상태로 과거 증거를 가리고 정지도 상태로 결정합니다. 백본 고정·컨트롤러 582파라미터.
✔ 초록: 3 LLM·16세트에서 토큰 62.6%·지연 44.6% 감소, 영역 배수 1.34 / 1.62 / 1.76 / 2.51×.
✔ Llama Table 1 도메인 평균 QS 65.8 · S&C 58.4 · GU 70.4 · LCR 31.9. 최강 non-SoT 대비 +10.3/+15.9/+6.8/+10.1점(§3.2).
✔ VLM: 평균 +3.8점, 탐색 대비 tok −74.9%·lat −73.5%. 제한 접근 38.2%/36.5%, Judge 합의 84.1%.
✔ Llama §3.3의 −52.6%/−66.4%는 샘플·탐색 대비 단독 수치. 초록 집계와 범위를 구분합니다. 이 글은 PDF·초록을 대조한 공개 요약이며 재실행 재현은 하지 않았습니다.
읽은 범위: arXiv abs HTML 초록 전문 + PDF(paper.pdf) 본문 §1–5·Table 1–6·Figure 1–4 화면 추출. HTML 실험판에서 Code/Project 링크 확인. 부록 전량·재학습은 하지 않음.
공식 링크
- arXiv abs: https://arxiv.org/abs/2609.16055
- PDF: https://arxiv.org/pdf/2609.16055
- HTML: https://arxiv.org/html/2609.16055
- Code: https://github.com/GongZhiren/State-of-Thought
- Project: https://gongzhiren.github.io/SoT-website/
- Tutorial: https://gongzhiren.github.io/SoT-website/tutorial.html
제목: State of Thought Enables Endogenous Reasoning (Gong et al., arXiv:2609.16055, 20
26-09-13).
