
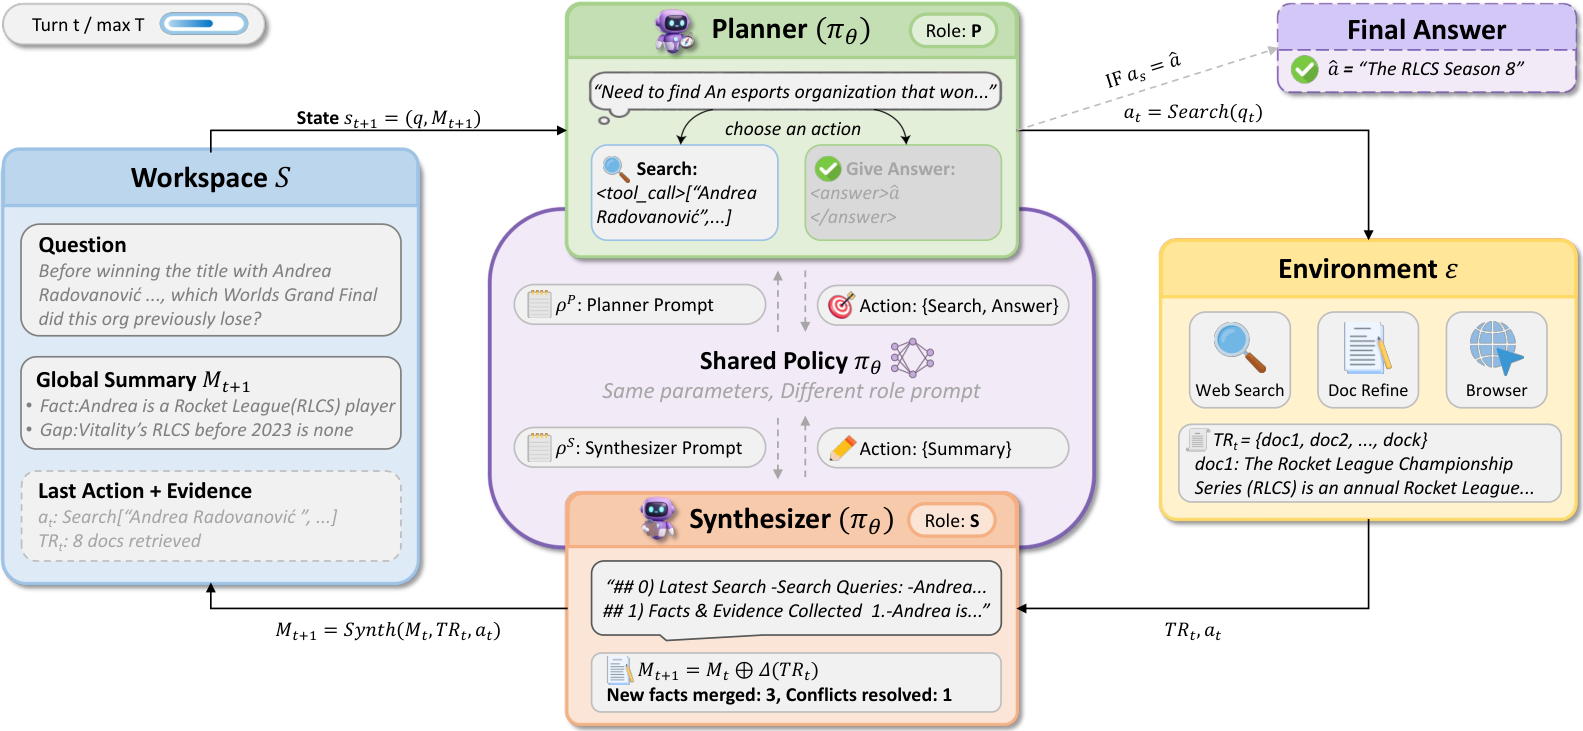
「Figure 1, Wu et al., arXiv:2609.29444」 IterSynth 전체 구조. 한 모델이 Planner(검색·답변)와 Synthesizer(요약 갱신) 역할을 번갈아 맡고, 질문과 누적 요약(q, M_t)만으로 다음 단계를 이어 갑니다.
오늘 읽은 논문
IterSynth: Rethinking Deep Search Agents via Role-Decoupled Iterative Synthesis
Xingyu Wu · Yuchen Yan · Zhengxi Lu · Siqi Chen · Xin Zhang · Aiting Liu · Chao Deng · Jie Liu · Jin Ma · Jian Shao · Jun Xiao · Yongliang Shen (Zhejiang University / Tencent), arXiv:2609.29444, 2026-09-24. 코드: https://github.com/Tencent/IterSynth
긴 검색을 맡긴 에이전트는 질문을 쪼개고, 검색을 내고, 증거를 모아 답을 써야 합니다. 그런데 ReAct식 한 정책·한 컨텍스트는 이력이 쌓일수록 역할이 뒤섞이고, 쓸 만한 증거는 노이즈에 가립니다. Appendix H는 64K에서도 BrowseComp-100의 ReAct 궤적 중 59%가 넘는 경우가 답을 내기 전에 컨텍스트를 소진한다고 적습니다.
이 논문은 그 병목을 Planner와 Synthesizer의 교대로 겨냥합니다. 같은 Qwen3-8B 정책이 역할 프롬프트만 바꿔 가며, 요약 상태 Mt를 검색의 영속 상태로 둡니다. 학습은 SFT 약 10K 궤적 뒤 Role-Decoupled Policy Optimization(RDPO)입니다.
답을 먼저 말하면, IterSynth-8B는 다섯 deep-search 벤치 평균 50.7로, ≤8B 구간 직전 최강 MiroThinker-v1.0-8B(46.5)보다 +4.2입니다. BrowseComp-ZH는 55.4로 같은 소형 베이스라인(40.2) 대비 +15.2입니다. 이 글은 arXiv abs·HTML·PDF의 Abstract·§3–§5·Table 1·학습 ablation·역할 교체·Appendix H를 대조한 공개 요약입니다. 벤치를 재평가하거나 모델을 재학습하지 않았습니다.
※ AI·에이전트 논문의 공개 요약이며, 특정 제품·서비스 권고가 아닙니다. 수치는 원문 표·본문에 있는 것만 옮깁니다.
1. 한눈에 보는 숫자
표에 적힌 값만 옮깁니다. 출처는 Abstract, Table 1, ablation·역할 교체 표, Appendix H입니다.
항목수치출처
| 다섯 벤치 평균 | 50.7 (MiroThinker-v1.0-8B 46.5, Δ +4.2) | Table 1·Abstract |
| BrowseComp / BCzh / GAIA / Xb05 / Xb10 | 30.9 / 55.4 / 55.3 / 66.0 / 46.0 | Table 1 |
| BCzh vs 소형 최강 | 55.4 vs 40.2 (+15.2) | Table 1·§4.2 |
| SFT → GRPO → RDPO | 44.1 → 48.9 → 50.7 (w/o RD 47.2) | ablation |
| 역할 교체 평균 | full 58.9 · Synth→base 41.5 (Δ−17.4) · Planner→base 17.8 (Δ−41.1) | role-swap |
| BCzh Planner 교체 | 55.4 → 7.9 | role-swap |
| Claude-4.5-Opus 프롬프트 | ReAct 60.6 / IterResearch 63.2 / IterSynth 66.1 | prompting |
| Claude BCzh | ReAct 60.2 → IterSynth 70.2 (+10.0) | Abstract·prompting |
| ReAct 64K BC-100 미완료 | >59% (DeepSeek/Claude ~59–65%) | Appendix H |
| IterSynth context-exhaustion | <5% | Appendix F.3 |
헤드라인 한 줄은 「8B 평균 50.7, BCzh +15.2」입니다. 같은 표의 두 번째 줄은 「역할만 나누는 게 아니라, RDPO가 Planner 쪽을 더 크게 끌어올린다」입니다.
2. IterSynth가 하는 일 — Planner와 Synthesizer
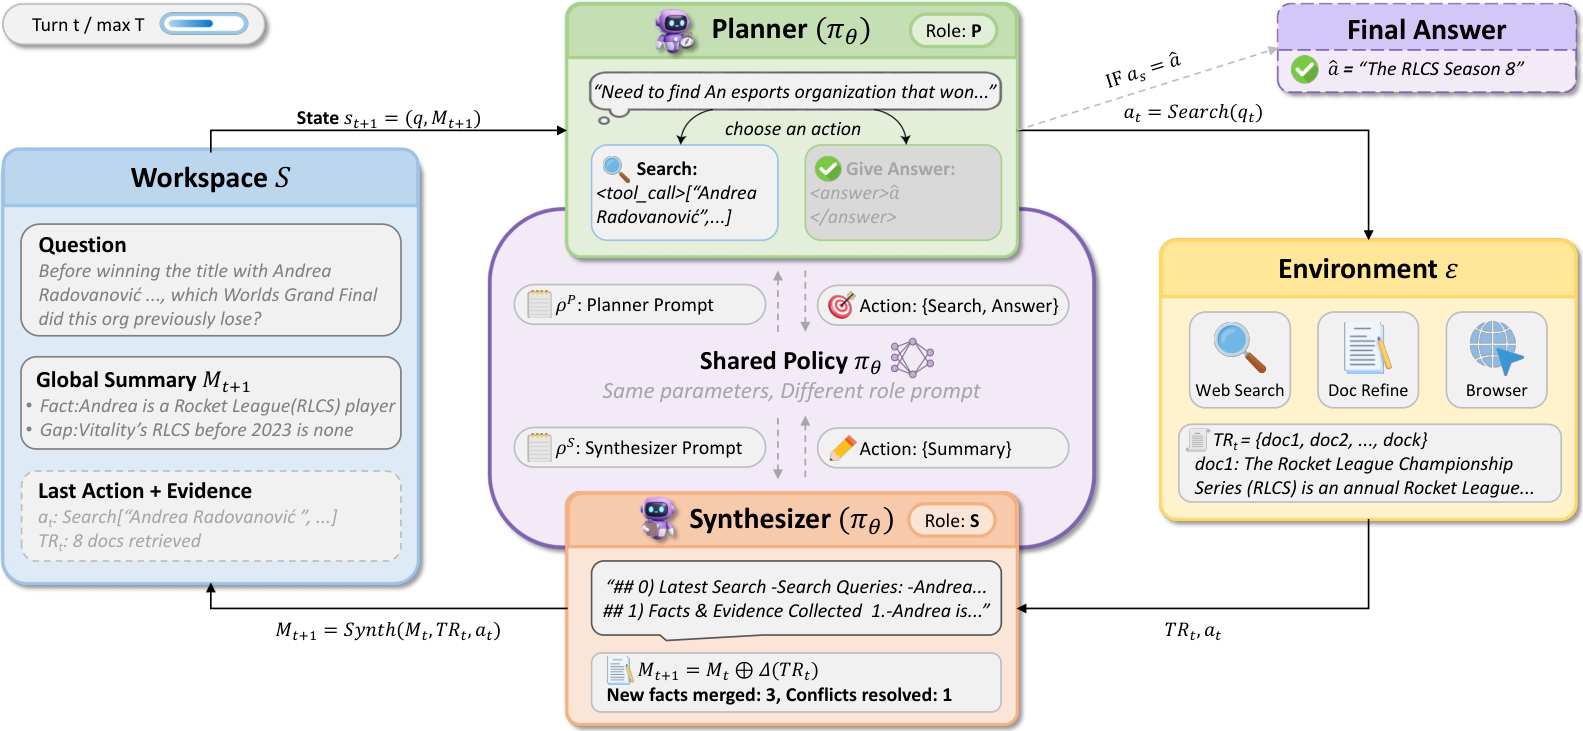
「Figure 1, Wu et al., arXiv:2609.29444」 IterSynth 파이프라인. Planner가 검색하거나 최종 답을 내면, Synthesizer가 새 근거를 전체 요약에 합칩니다. 컨텍스트는 반복할 때마다 새로 구성됩니다.
Figure 1이 한 장을 보여 줍니다. 각 반복에서 공유 정책이 두 역할로 교대합니다.
Planner는 원래 질문 q와 전역 요약 Mt만 보고, 다음 검색 질의를 내거나 최종 답으로 종료합니다. 전체 이력을 들고 가지 않습니다. Synthesizer는 검색으로 돌아온 증거를 읽고, 쓸모 있는 발견을 넣고, 모순을 정리하고, 노이즈를 걸러 Mt+1을 만듭니다. 질의나 최종 답은 쓰지 못합니다. 상태는 st=(q,Mt)이고, 다음 반복의 활성 컨텍스트는 (q,Mt+1)로 다시 조립됩니다.
역할은 프롬프트·정보 접근·허용 행동으로만 갈라집니다. 파라미터는 하나입니다. 멀티에이전트처럼 모델을 늘리지 않고 전문화 이득을 가져가겠다는 그림입니다.
3. 학습 — SFT 약 10K와 RDPO
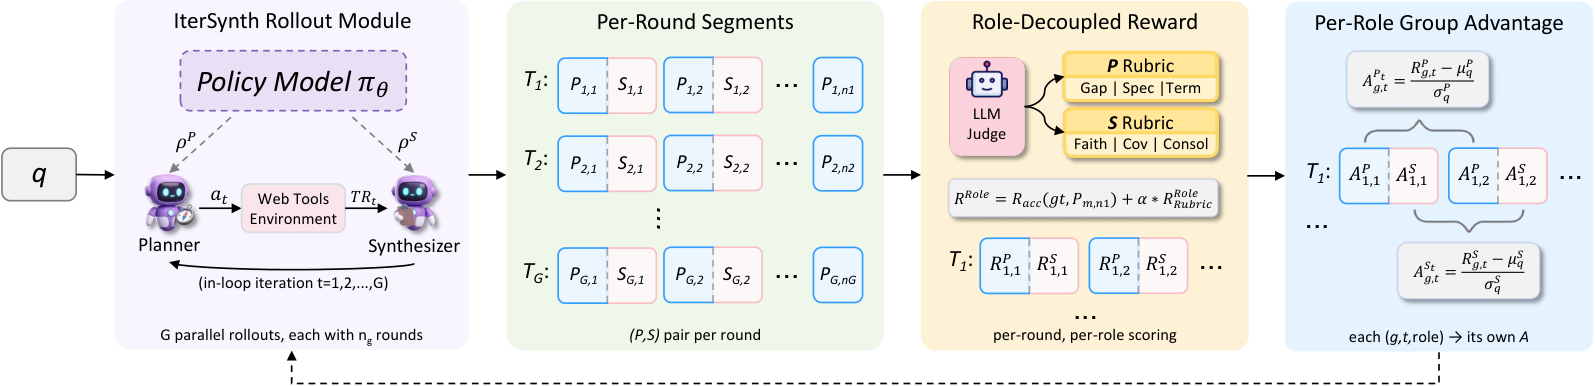
「Figure 2, Wu et al., arXiv:2609.29444」 역할 분리 정책 최적화(RDPO). 보상을 Planner 몫과 Synthesizer 몫으로 나누고, 이점(advantage)을 역할별로 따로 정규화합니다.
백본은 Qwen3-8B입니다. 1단계는 콜드스타트 SFT입니다. 공개 deep-search 데이터와 합성 질문으로 프론티어 모델이 Planner–Synthesizer 궤적을 굴리고, 필터 뒤 약 10K 고품질 궤적이 남습니다.
2단계는 RDPO입니다. Figure 2처럼 최종 정답 신호와 턴별 rubric을 합친 뒤, Planner·Synthesizer 풀 안에서만 이점을 정규화합니다. 같은 composite reward를 쓰더라도 역할을 섞어 정규화하면(w/o RD) 신호가 얽힙니다. 메인 설정에서 α=0.5입니다.
4. 메인 결과 — 평균 50.7과 BCzh +15.2
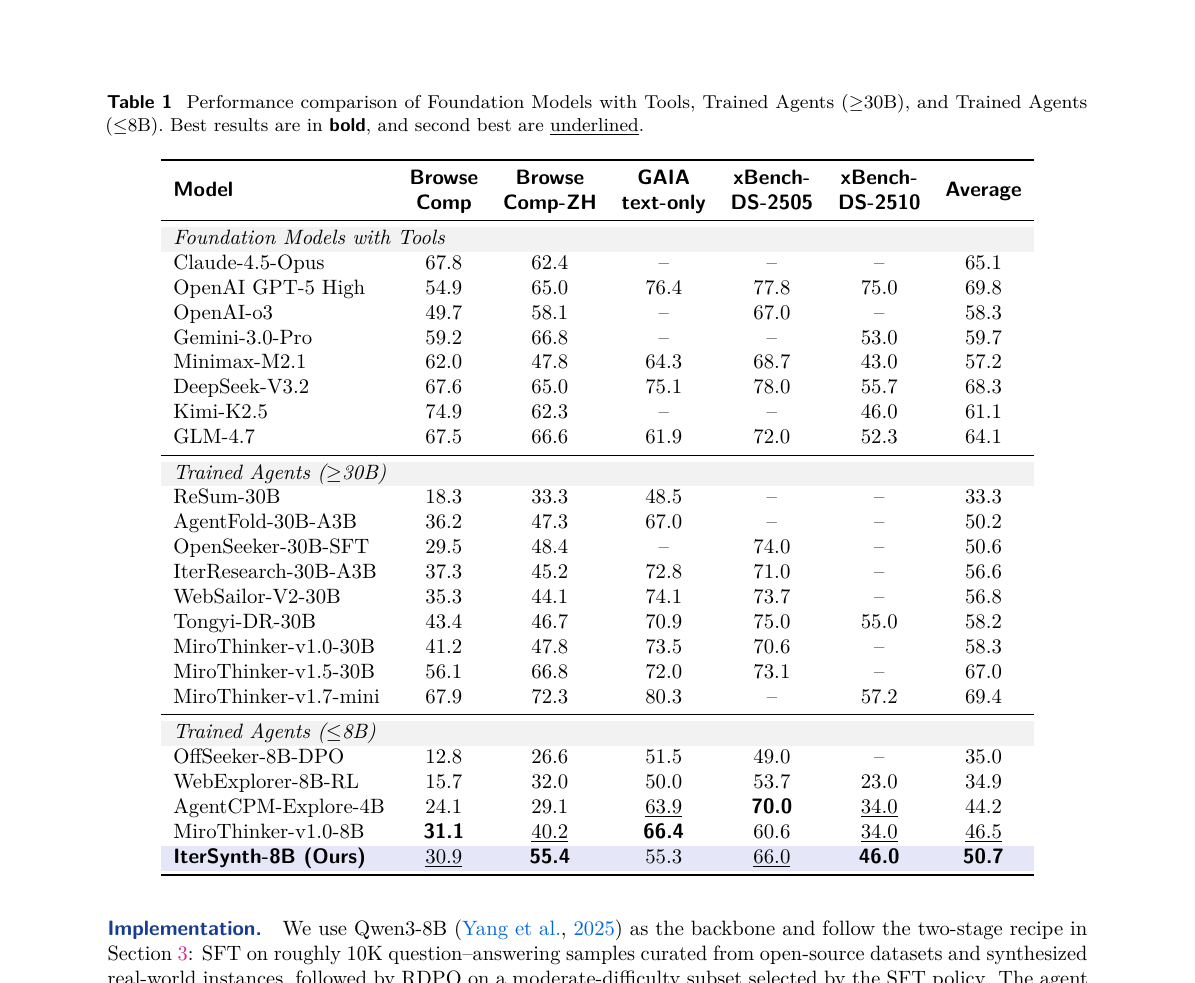
「Table 1, Wu et al., arXiv:2609.29444」 주요 결과 비교. IterSynth-8B는 8B 이하 학습형 에이전트 가운데 평균 50.7로 가장 높습니다(BrowseComp 30.9, BrowseComp-ZH 55.4, GAIA 55.3, xBench-2505 66.0, xBench-2510 46.0).
Table 1이 핵심입니다. ≤8B 구간에서 IterSynth-8B 평균 50.7이 최선이고, MiroThinker-v1.0-8B 46.5보다 +4.2입니다. BrowseComp-ZH 55.4는 같은 칸의 MiroThinker 40.2보다 +15.2입니다. xBench-DS-2510도 46.0 대 34.0입니다.
다만 절대값만 보면 BrowseComp는 30.9로 MiroThinker 31.1보다 소폭 낮고, GAIA-text-only 55.3은 MiroThinker 66.4보다 낮습니다. 평균을 끌어올린 칸은 BCzh와 xBench-2510 쪽입니다. 30B급과의 비교는 표에 적힌 범위만 옮깁니다. 이 글은 재평가하지 않았습니다.
5. 학습 ablation — SFT에서 RDPO까지
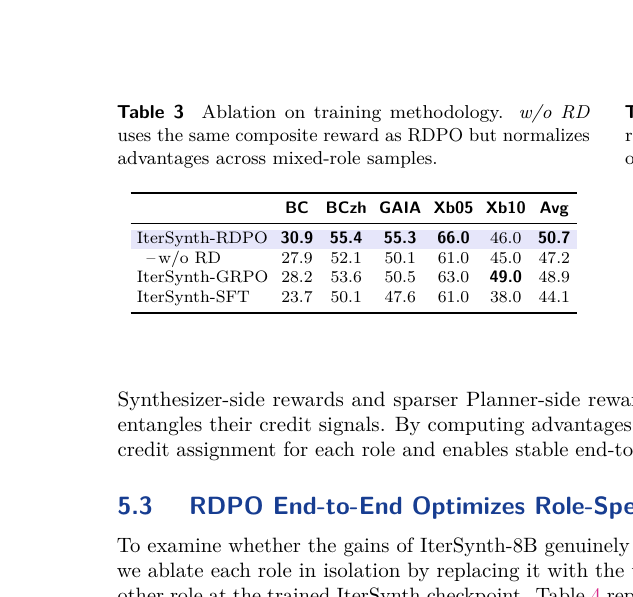
「Table 3(PDF 기준, HTML판 Table 2), Wu et al., arXiv:2609.29444」 학습 방법 비교. 평균이 SFT 44.1에서 GRPO 48.9, RDPO 50.7로 오르고, 역할 분리를 빼면(w/o RD) 47.2입니다.
학습만 바꾼 ablation에서 SFT 평균 44.1, outcome-only GRPO 48.9, RDPO 50.7입니다. w/o RD는 47.2로 GRPO보다도 낮습니다. Xb10만 GRPO(49.0)가 RDPO(46.0)보다 높고, 나머지와 평균에서는 RDPO가 앞섭니다. 논문은 특히 BrowseComp·BrowseComp-ZH에서 RDPO 이득이 두드러진다고 씁니다.
6. 역할 교체 — Planner가 더 비싸다
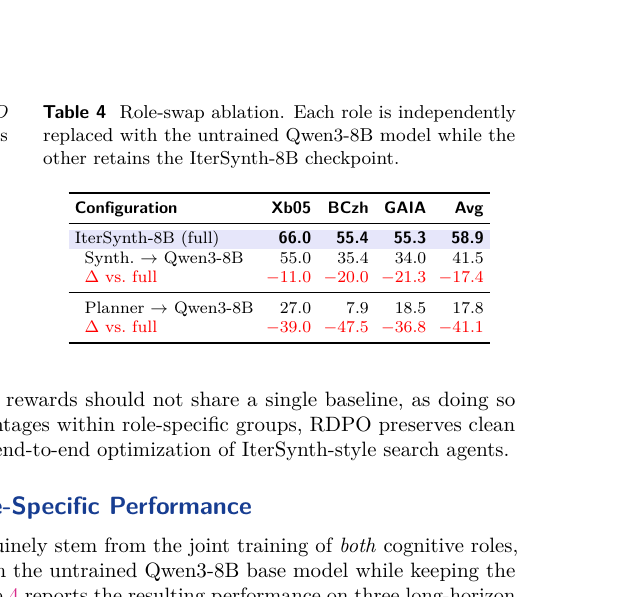
「Table 4(PDF 기준, HTML판 Table 3), Wu et al., arXiv:2609.29444」 역할 교체 실험. 전체 모델은 58.9인데, Synthesizer만 기본 모델로 바꾸면 41.5(−17.4), Planner만 바꾸면 17.8(−41.1)입니다. BrowseComp-ZH에서는 Planner를 바꾸면 55.4가 7.9로 떨어집니다.
한 역할만 미학습 Qwen3-8B로 바꾸면, 세 벤치 평균이 full 58.9에서 Synth 교체 시 41.5(Δ−17.4), Planner 교체 시 17.8(Δ−41.1)로 떨어집니다. BrowseComp-ZH만 보면 Planner 교체 시 55.4→7.9입니다. 약한 Planner는 나쁜 하위 질의를 내고 궤적 전체의 증거를 오염시킨다는 쪽이 저자들의 읽기입니다.
7. 프롬프트만으로도, 그리고 컨텍스트 소진
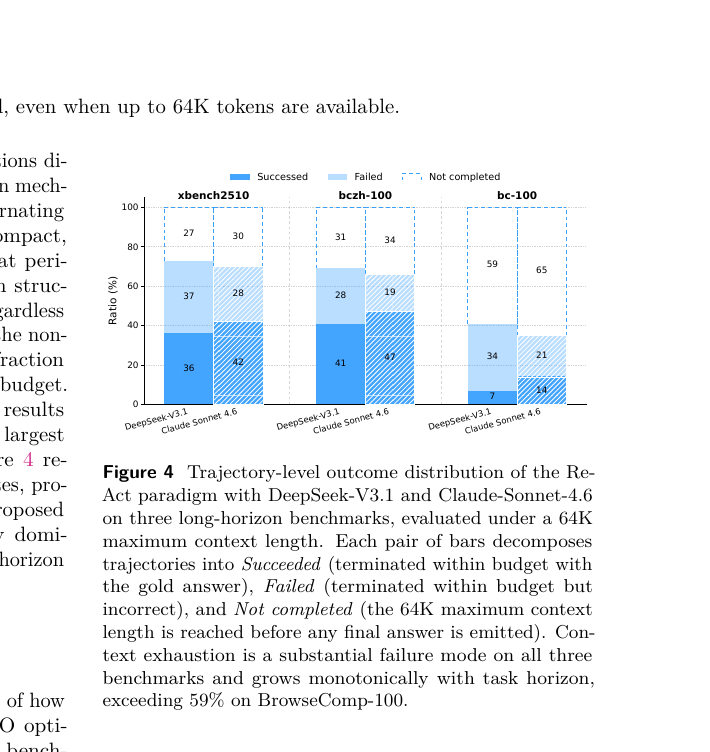
「Appendix H 그림, Wu et al., arXiv:2609.29444」 64K 컨텍스트에서 ReAct를 돌린 결과. BrowseComp-100에서 DeepSeek와 Claude 모두 약 59~65%를 끝내지 못했고, 대부분 컨텍스트가 바닥나서 멈췄습니다.
학습 없이 워크플로만 바꾼 비교에서 Claude-4.5-Opus는 ReAct 평균 60.6, IterResearch 63.2, IterSynth 66.1입니다. BrowseComp-ZH만 보면 ReAct 60.2 → IterSynth 70.2(+10.0)입니다. DeepSeek-V3.1에서도 ReAct 대비 평균 +4.5입니다.
Appendix H는 DeepSeek-V3.1·Claude-Sonnet-4.6을 동일 ReAct로 돌렸을 때, BrowseComp-100에서 미완료가 약 59–65%로 지배적이라고 보여 줍니다. Appendix F.3은 IterSynth의 context-exhaustion을 5% 미만으로 적습니다. 메인 결과에서 BCzh 이득이 큰 이유와, 미완료율이 높은 벤치가 겹친다는 점을 논문은 서로 비춥니다.
8. ✔ 요약과 공식 링크
✔ IterSynth는 한 공유 LLM 안에서 Planner·Synthesizer를 교대하고, 요약 Mt를 검색의 영속 상태로 둡니다.
✔ IterSynth-8B는 다섯 벤치 평균 50.7(≤8B 최강 대비 +4.2). BrowseComp-ZH 55.4(+15.2 vs MiroThinker-v1.0-8B 40.2).
✔ 학습은 SFT 44.1 → GRPO 48.9 → RDPO 50.7. w/o RD는 47.2. Planner 교체 시 평균 Δ−41.1, BCzh 55.4→7.9.
✔ 프롬프트만으로 Claude-4.5-Opus 평균 66.1, BCzh ReAct 대비 +10.0. ReAct 64K BC-100 미완료 >59%, IterSynth context-exhaustion <5%.
✔ 이 글은 arXiv abs·HTML·PDF를 대조한 공개 요약이며, 벤치 재평가·재학습은 하지 않았습니다.
읽은 범위: arXiv abs + HTML(v1) + PDF(29pp) Abstract·§1·§3–§5·Table 1·ablation·role-swap·Appendix F.3·H. 라이브 벤치 재실행은 하지 않음.
공식 링크
- arXiv abs: https://arxiv.org/abs/2609.29444
- HTML: https://arxiv.org/html/2609.29444v1
- PDF: https://arxiv.org/pdf/2609.29444
- GitHub: https://github.com/Tencent/IterSynth
제목: IterSynth: Rethinking Deep Search Agents via Role-Decoupled Iterative Synthesis (Wu et al.; Zhejiang University / Tencent; arXiv:2609.29444, 2026-09-24).