
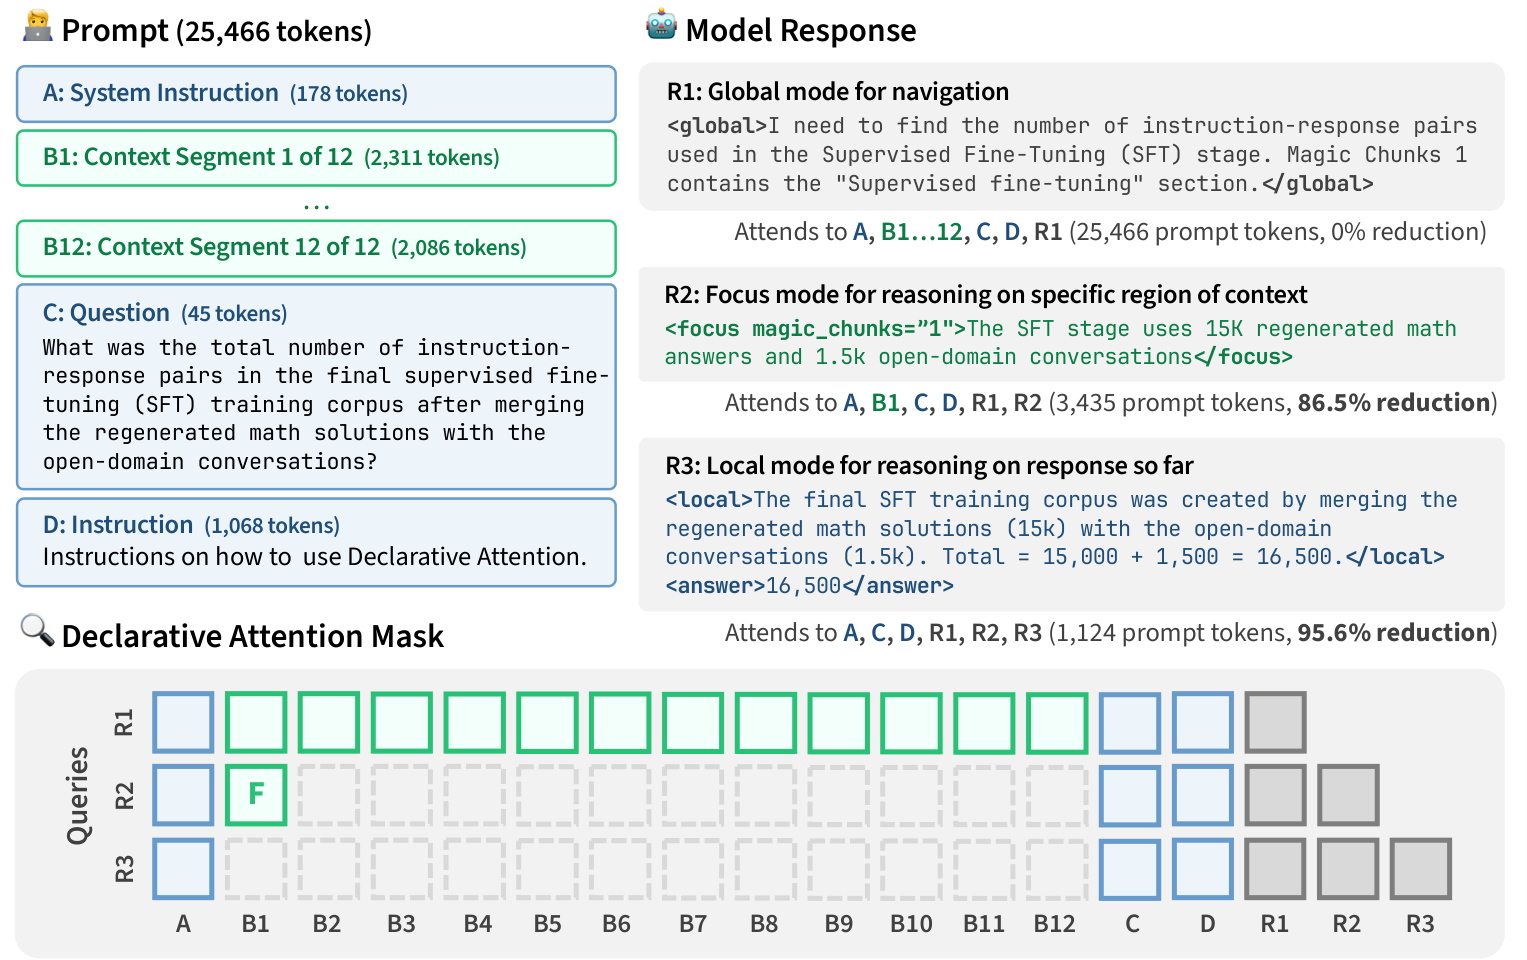
「Figure 1, Ho et al., arXiv:2609.02737」 Declarative Attention: model declares global / focus / local spans; engine masks most KV-cache reads.
오늘 읽은 논문
Language Models Can Control Their Own Attention
Namgyu Ho · Huzama Ahmad · Woosung Koh · Se-Young Yun (KAIST AI) · Tal Schuster · Cicero Nogueira dos Santos (Google DeepMind), arXiv:2609.02737, 2026-09-02.
긴 문서를 읽을 때 사람은 문장마다 처음부터 다시 훑지 않습니다. 그런데 디코딩 때 글로벌 어텐션은 KV 캐시를 통째로 다시 읽습니다. 1M 토큰 대화에서 「앞에서 말한 숫자」만 물어도, 생성 토큰마다 전체 캐시를 열어 보는 셈입니다.
이 논문은 어디를 볼지 모델이 스스로 선언하게 해서 그 비용을 줄입니다. Declarative Attention(DA)은 CoT 안에 global / focus / local 모드를 찍고, 추론 엔진이 그 태그를 툴 호출처럼 읽어 대부분의 KV 읽기를 건너뜁니다. 외부 스코어러도, 추가 학습도 없습니다.
답을 먼저 말하면, 제로샷으로 15개 롱컨텍스트 과제에서 Gemma-4-31B는 어텐션 토큰을 52.0% 줄이고 정확도는 1.27pp(87.01→85.74)만 떨어졌습니다. Qwen-3.6-27B는 31.1% 절감에 정확도 2.75pp 하락(85.31→82.56)입니다. 마스크 없는 DA 프롬프트만으로는 토큰이 오히려 늘고, 절감의 거의 전부는 마스크에서 옵니다. 이 글은 arXiv abs·HTML·PDF의 Abstract·§1–§2·§4–§6·Table 2–3·Figure 1–5를 대조한 공개 요약입니다.
1. 한눈에 보는 숫자
표에 적힌 값만 옮깁니다. 출처는 Abstract와 Table 2·§5입니다.
| 항목 | 수치 | 출처 |
|---|---|---|
| 과제 수 | 15 long-context sources | Abstract·§4 |
| Gemma-4-31B 어텐션 | 52.0%↓ (13.43M → 6.45M) | Table 2·§5.1 |
| Gemma 정확도 | 1.27pp↓ (87.01% → 85.74%) | Table 2 |
| Qwen-3.6-27B 어텐션 | 31.1%↓ (22.54M → 15.52M) | Table 2·§5.1 |
| Qwen 정확도 | 2.75pp↓ (85.31% → 82.56%) | Table 2 |
| 마스크 vs DA-nm | 어텐션 71.1%↓ (Gemma) | §5.1 |
| decode wall-clock (roofline) | Gemma 0.71× · Qwen 0.77× | Table 3 |
| 최장 구간 절감 | 응답당 최대 약 21M 토큰 | §5.3 |
헤드라인 한 줄은 「선언하니 52%, 정확도는 1.27pp」입니다. 이 표에서 읽을 두 번째 메시지는 「프롬프트만으로는 안 되고, 절약은 마스크에서 나온다」입니다.
2. DA가 하는 일 — global / focus / local
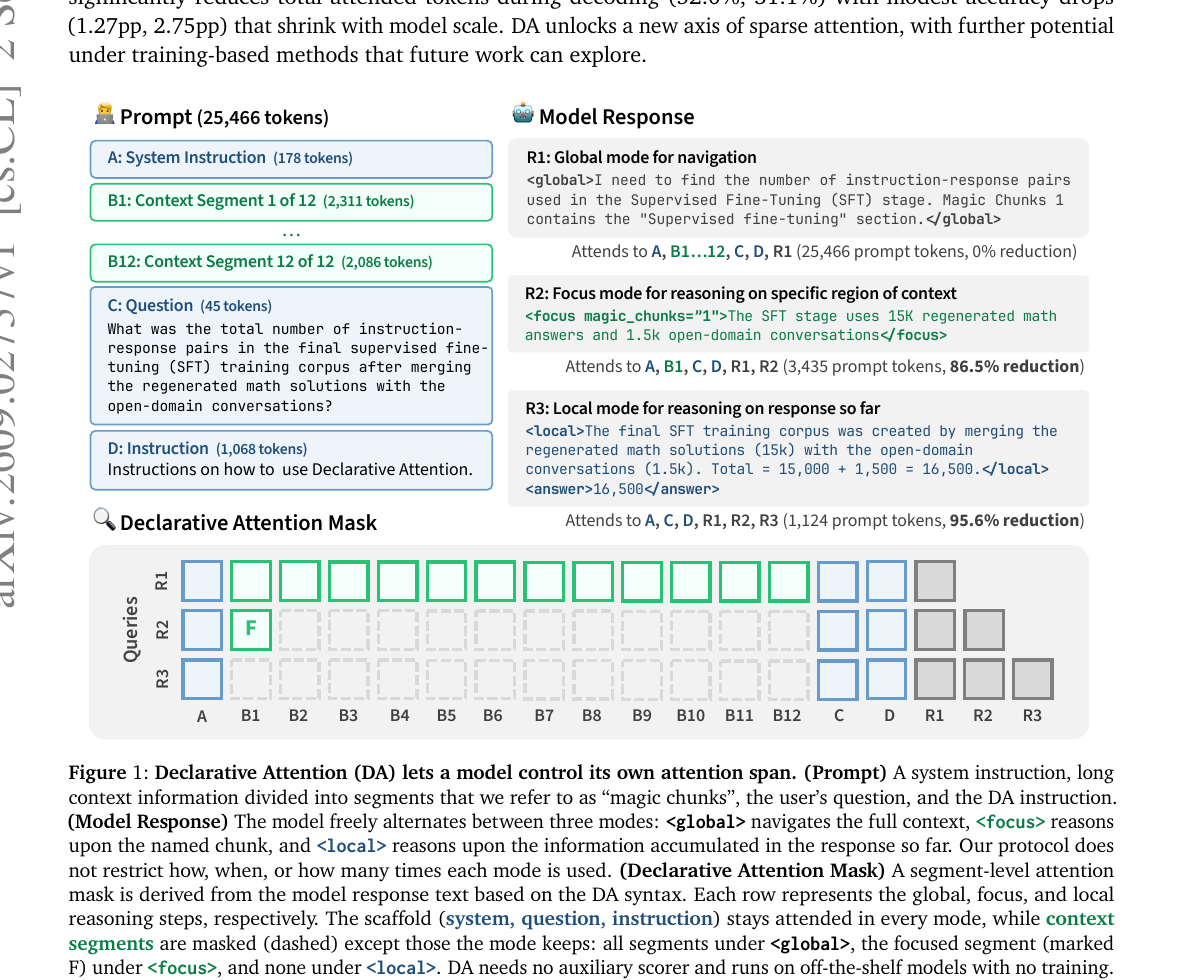
「Figure 1, Ho et al., arXiv:2609.02737」 Prompt magic chunks, model response modes, and the declarative attention mask. Scaffold stays attended; focus keeps one segment (F); local keeps none of the context segments.
Figure 1이 전체 흐름을 한 장에 보여 줍니다. 긴 입력은 약 2K 토큰 단위 magic chunk로 쪼개져 들어가고, 모델은 응답 안에서 모드를 자유롭게 바꿉니다.
global은 전체 컨텍스트를 보며 다음에 볼 구간을 고릅니다. 절감은 거의 없습니다. focus는 태그로 이름 붙인 청크만 봅니다. Figure 1 예시에서는 프롬프트 토큰의 86.5%를 건너뜁니다. local은 컨텍스트 청크는 전부 가리고, 지금까지 쓴 응답과 스캐폴드만 봅니다. 같은 예시에서 95.6% 절감입니다.
시스템·질문·DA 지시(스캐폴드)는 모든 모드에서 남습니다. 엔진은 여는 태그의 >에서 상태를 바꾸고, vLLM의 KV 블록 테이블을 고쳐 FlashAttention이 읽을 블록 수를 줄입니다.
3. 실험 설계 — 15개 과제, Vanilla / DA-nm / DA
평가 모델은 Gemma-4-{31B,12B,E4B}와 Qwen-3.6-27B·Qwen-3.5-{9B,4B}입니다. 메인 표에는 Gemma-4-31B와 Qwen-3.6-27B 결과가 실렸습니다. 벤치마크는 RULER, LongBench v1/v2, LooGLE, ZeroSCROLLS에서 고른 15개 소스이며, 단일 스팬 검색·추론과 다중 스팬 추론으로 나뉩니다.
비교 조건은 세 가지입니다. Vanilla는 일반 인과 어텐션, DA-nm은 DA 프롬프트(청크·모드 지시)만 쓰고 마스크는 끄며, DA는 프롬프트 + 선언 마스크입니다. 채점은 LLM 심사로 하고, 형식 실패는 오답으로 셉니다. thinking 모드는 DA 프로토콜을 잘 따르지 못해 꺼 두었습니다.
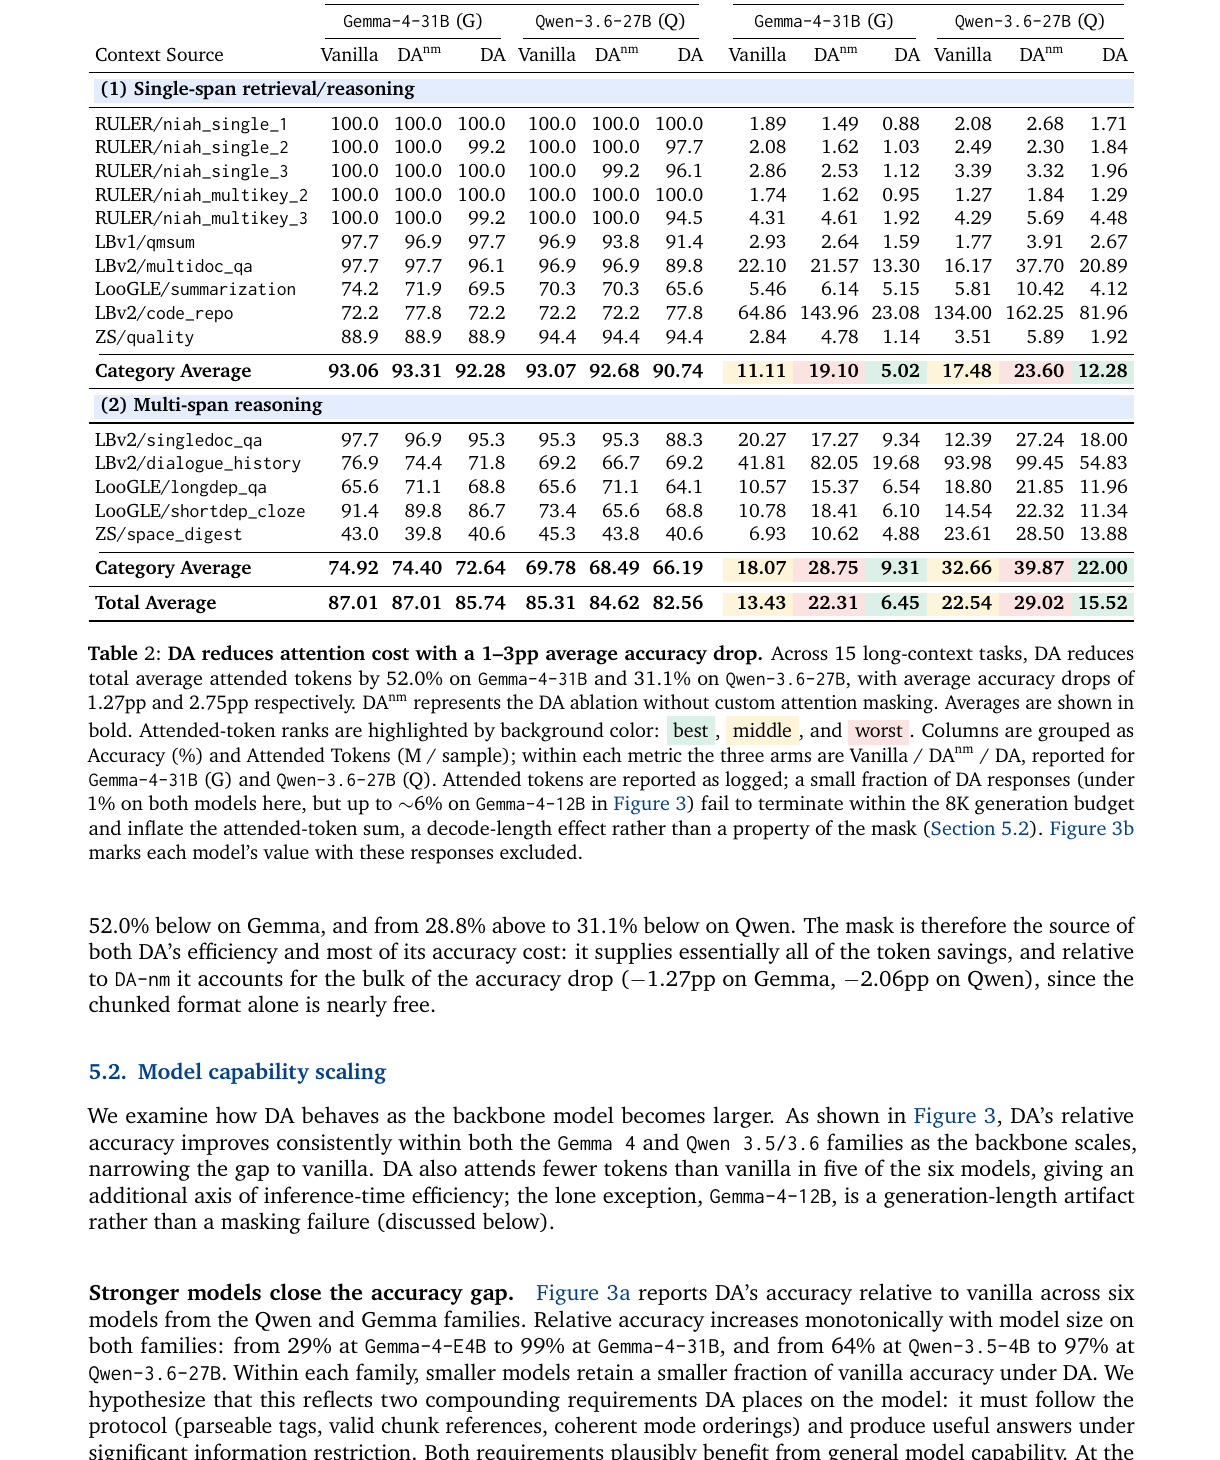
「Table 2, Ho et al., arXiv:2609.02737」 Accuracy and attended tokens (M/sample) for Vanilla / DA-nm / DA on Gemma-4-31B and Qwen-3.6-27B across 15 sources.
4. 메인 결과 — 52%와 1.27pp
Table 2가 핵심입니다. 15개 과제 평균으로 Gemma는 어텐션 52.0% 절감·정확도 1.27pp 하락, Qwen은 31.1%·2.75pp입니다. Gemma는 15개 과제 중 7개에서 Vanilla와 같거나 더 나았고, Qwen은 5개입니다.
절감이 큰 쪽은 긴 컨텍스트입니다. code_repo에서 Gemma는 응답당 약 41.8M, Qwen은 약 52.0M 토큰을 덜 봤고, dialogue_history도 각각 약 22.1M·39.1M입니다. 짧은 과제 일부에서는 Qwen의 생성이 길어져 어텐션이 Vanilla보다 늘기도 합니다.
5. 마스크가 절약의 전부다
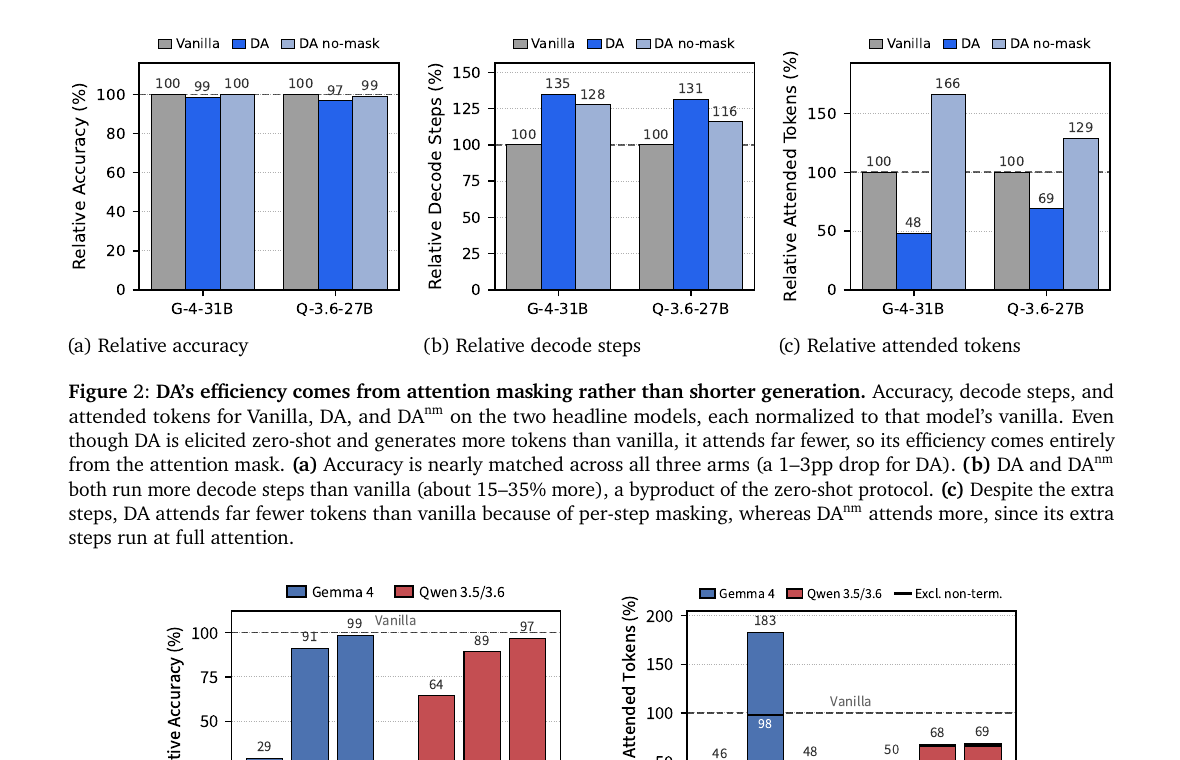
「Figure 2, Ho et al., arXiv:2609.02737」 Relative accuracy, decode steps, and attended tokens for Vanilla / DA / DA-nm. Extra steps come from the protocol; net savings come from the mask.
Figure 2가 세 조건을 나란히 보여 줍니다. DA와 DA-nm 모두 Vanilla보다 decode step이 대략 15–35% 많습니다. 제로샷 프로토콜이 생성 길이를 늘리기 때문입니다.
그런데 DA-nm의 어텐션 토큰은 Gemma에서 Vanilla보다 66.2% 많고, Qwen에서는 28.8% 많습니다. 마스크를 켠 DA는 그 오버헤드를 뒤집습니다. DA-nm 대비 어텐션을 Gemma 71.1%, Qwen 46.5% 깎아 Vanilla 아래로 내려보냅니다. 정확도 비용의 상당 부분도 마스크에서 옵니다. 청크 프롬프트 자체는 Gemma에서 정확도 손실이 거의 없습니다(87.01=87.01).
6. 스케일과 컨텍스트 길이
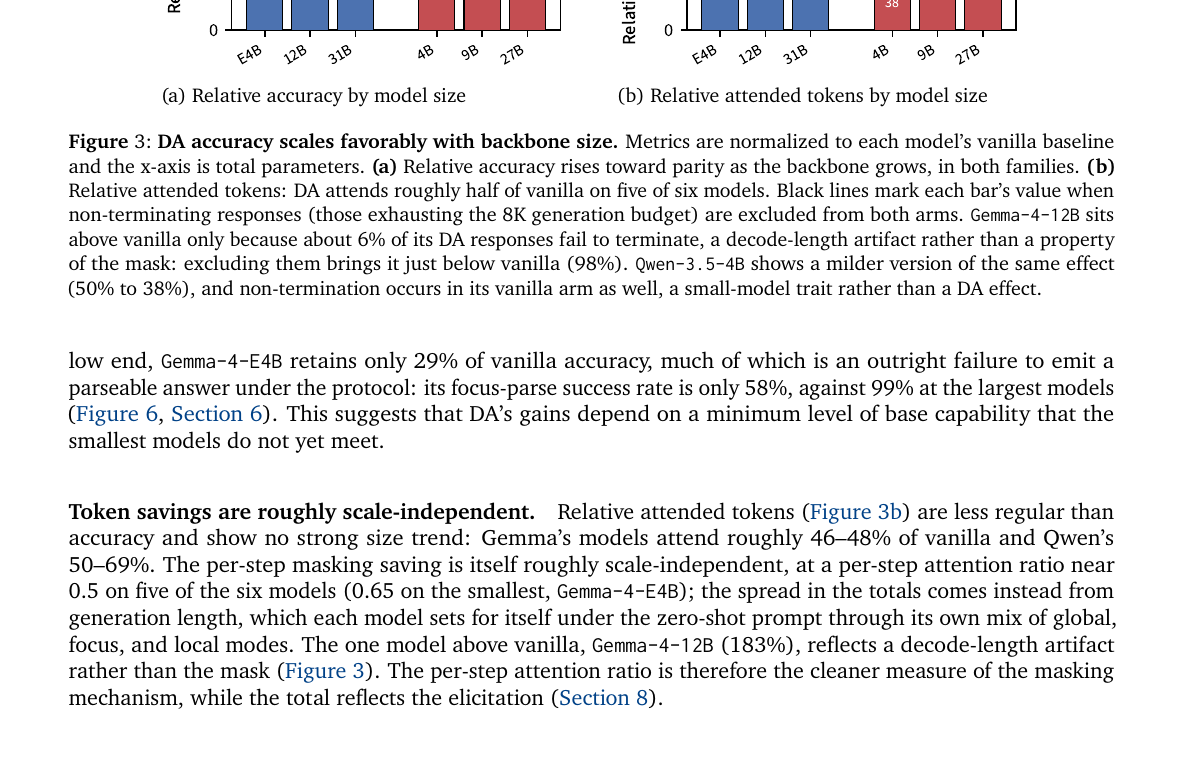
「Figure 3, Ho et al., arXiv:2609.02737」 Relative accuracy and attended tokens by model size. Accuracy gap closes toward vanilla as the backbone scales.
Figure 3은 백본이 커질수록 Vanilla 대비 상대 정확도가 올라감을 보여 줍니다. Gemma-4-E4B의 29%대에서 Gemma-4-31B의 약 99%까지, Qwen도 4B의 64%대에서 27B의 약 97%까지입니다. 작은 모델에서는 focus 태그부터 자주 깨집니다(E4B focus 성공률 58%, 대형 99%).
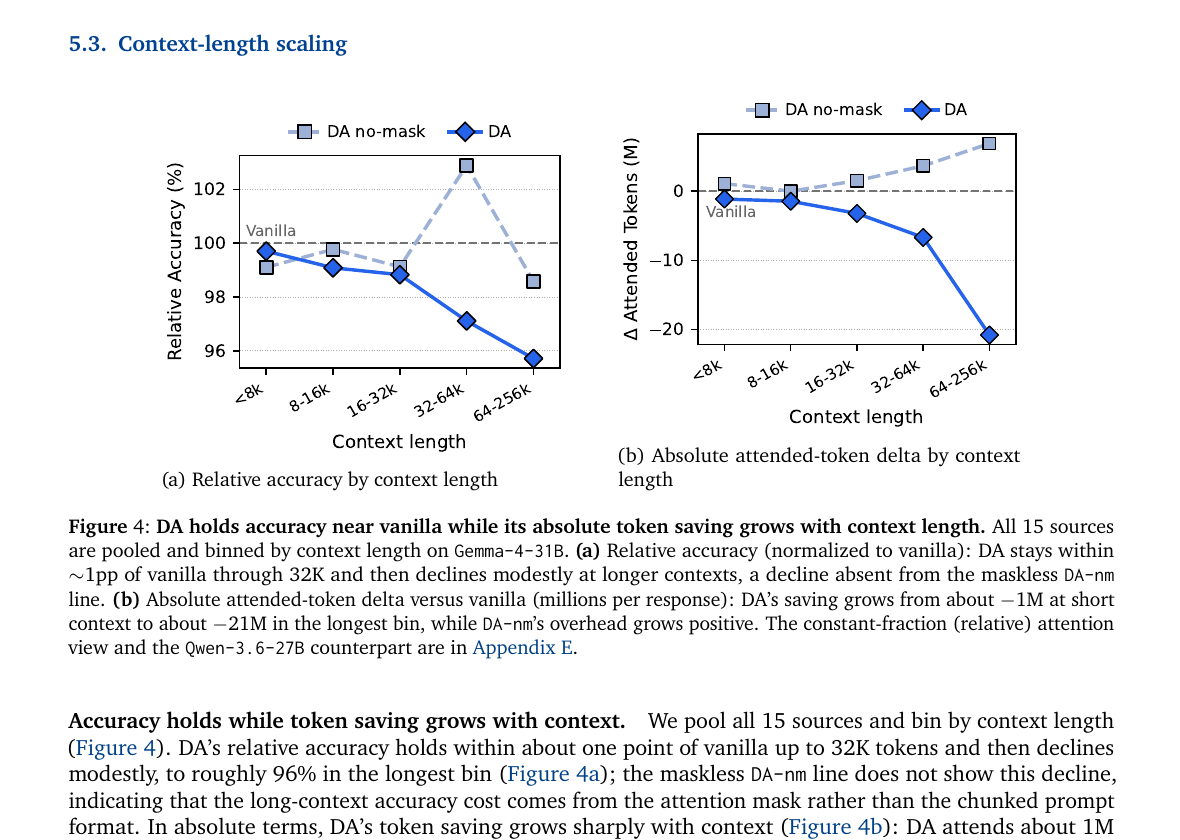
「Figure 4, Ho et al., arXiv:2609.02737」 Relative accuracy and absolute attended-token delta vs vanilla by context-length bin on Gemma-4-31B.
Figure 4는 컨텍스트가 길수록 절대 절감이 커짐을 보여 줍니다. Gemma에서 짧은 구간은 응답당 약 1M, 최장 구간은 약 21M 토큰을 덜 봅니다. 상대 정확도는 32K까지 Vanilla와의 차이가 약 1pp 이내이고, 그보다 길면 마스크 때문에 조금 더 벌어집니다.
7. 모드 믹스와 wall-clock
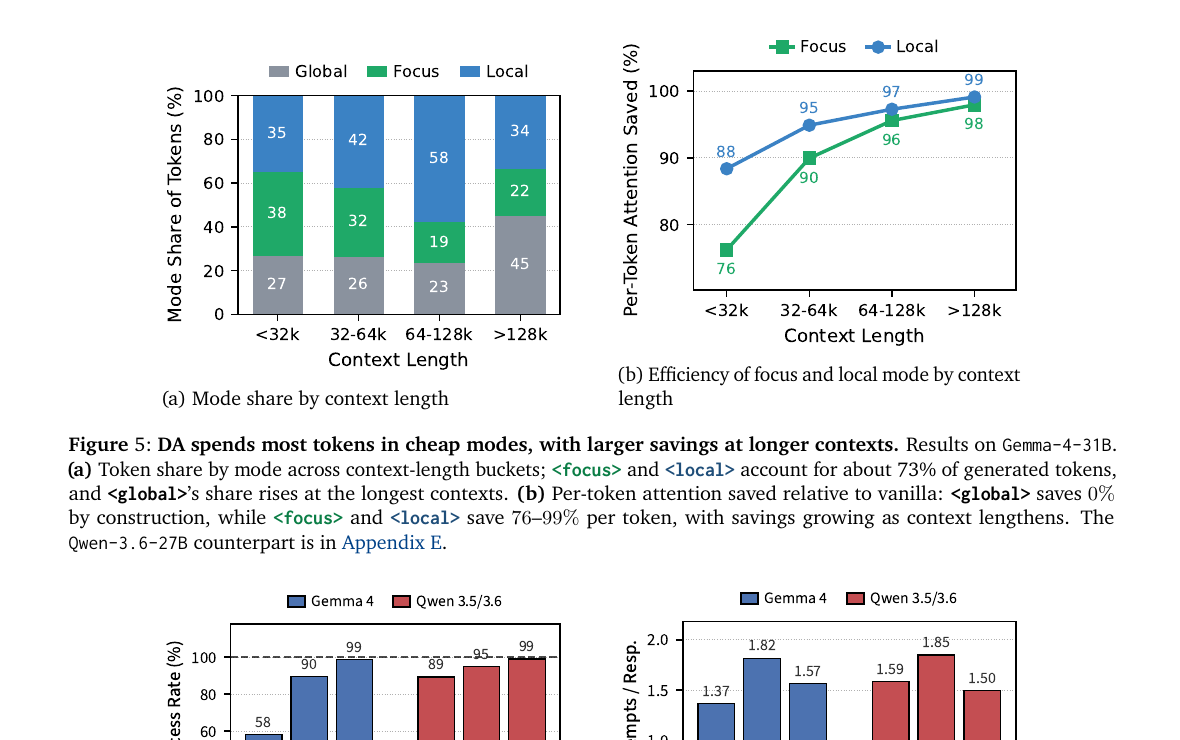
「Figure 5, Ho et al., arXiv:2609.02737」 Mode share and per-token attention savings for focus/local on Gemma-4-31B; cheap modes dominate generated tokens.
Figure 5 기준으로 Gemma-4-31B는 생성 토큰의 약 73%를 focus·local에 씁니다. 이 두 모드는 스텝당 어텐션을 Vanilla 대비 대략 76–99% 아낍니다. global 비중은 최장 구간에서 약 45%까지 올라가 절감을 제한합니다.
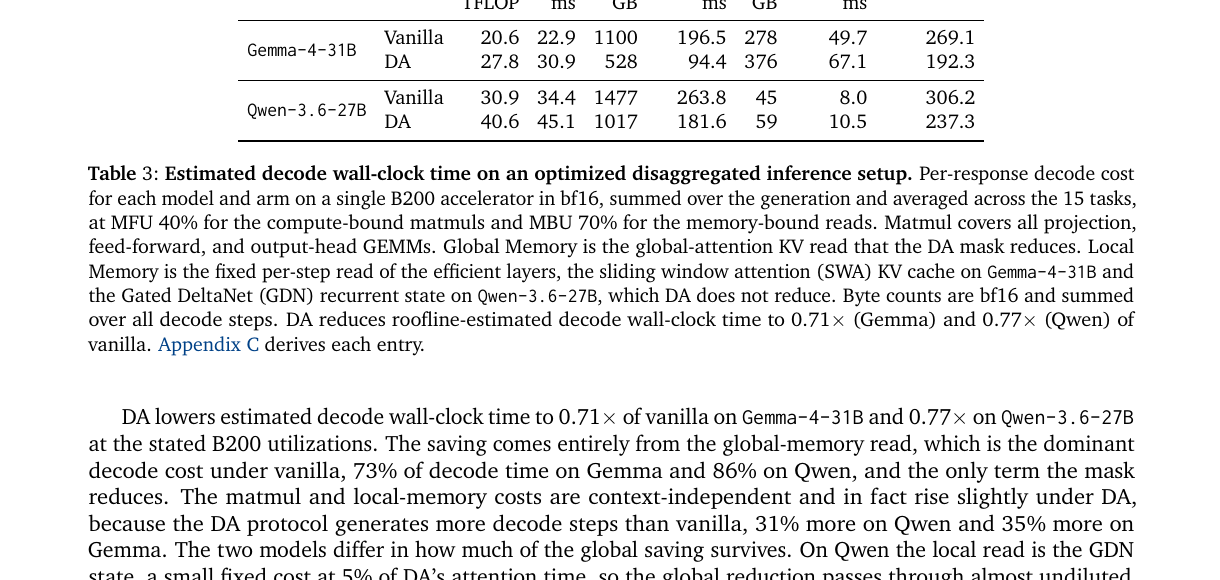
「Table 3, Ho et al., arXiv:2609.02737」 Roofline decode wall-clock on B200 bf16 (MFU 40%, MBU 70%): Gemma 0.71×, Qwen 0.77× of vanilla.
Table 3의 roofline 추정(B200, bf16, MFU 40%, MBU 70%)에서 decode wall-clock은 Gemma 0.71×, Qwen 0.77×입니다. 절감은 글로벌 어텐션 KV 읽기에서만 나오고, matmul·로컬 레이어(SWA/GDN) 비용은 스텝이 늘어 약간 커집니다. 실측 시간이 아니라 상한 추정이라는 점을 논문도 분명히 밝힙니다.
8. ✔ 요약과 공식 링크
✔ DA에서는 모델이 CoT에 global / focus / local을 선언하고, 엔진이 KV 블록 마스크를 만듭니다. 외부 스코어러·추가 학습이 필요 없습니다.
✔ 15개 과제 제로샷에서 Gemma-4-31B 어텐션 52.0%↓·정확도 1.27pp↓, Qwen-3.6-27B 31.1%↓·2.75pp↓.
✔ 마스크 없는 DA-nm은 토큰이 늘고, 마스크가 Gemma에서 DA-nm 대비 71.1%를 깎아 절약의 원천이 됩니다.
✔ roofline 추정 decode 시간은 Vanilla 대비 Gemma 0.71×·Qwen 0.77×입니다. 절대 절감은 컨텍스트가 길수록 커지며, 최장 구간에서는 응답당 약 21M 토큰입니다.
✔ 이 글은 arXiv abs·HTML·PDF를 대조한 공개 요약이며, vLLM 커스텀 서빙은 직접 재현하지 않았습니다.
읽은 범위: arXiv abs + HTML(v1) + PDF(42쪽) Abstract·§1–§2·§4–§6·Table 2–3·Figure 1–5. 커널·서빙 재실행과 thinking 모드 DA 실험은 하지 않았습니다.
공식 링크
- arXiv abs: https://arxiv.org/abs/2609.02737
- HTML: https://arxiv.org/html/2609.02737v1
- PDF: https://arxiv.org/pdf/2609.02737
제목: Language Models Can Control Their Own Attention (Ho, Ahmad, Koh, Yun, Schuster, Nogueira dos Santos; KAIST AI / Google DeepMind; arXiv:2609.02737, 2026-09-02).